29
미국 스타트업 투자사 Y Combinator(YC)가 2027년 겨울 배치 모집에 맞춰 「Requests for Startups」를 새로 냈습니다. 창업자들이 풀어 주기를 바라는 문제 11건을 적은 목록인데, 머리말 첫 문장이 이렇습니다. 「AI의 가장 큰 병목은 모델 밖으로 옮겨 가고 있다.」 YC는 공장과 데이터센터, 정부와 우주까지 실물 경제에 지능을 들여보낼 하드웨어와 인프라, 금융, 전문 소프트웨어를 찾는다고 적었습니다.
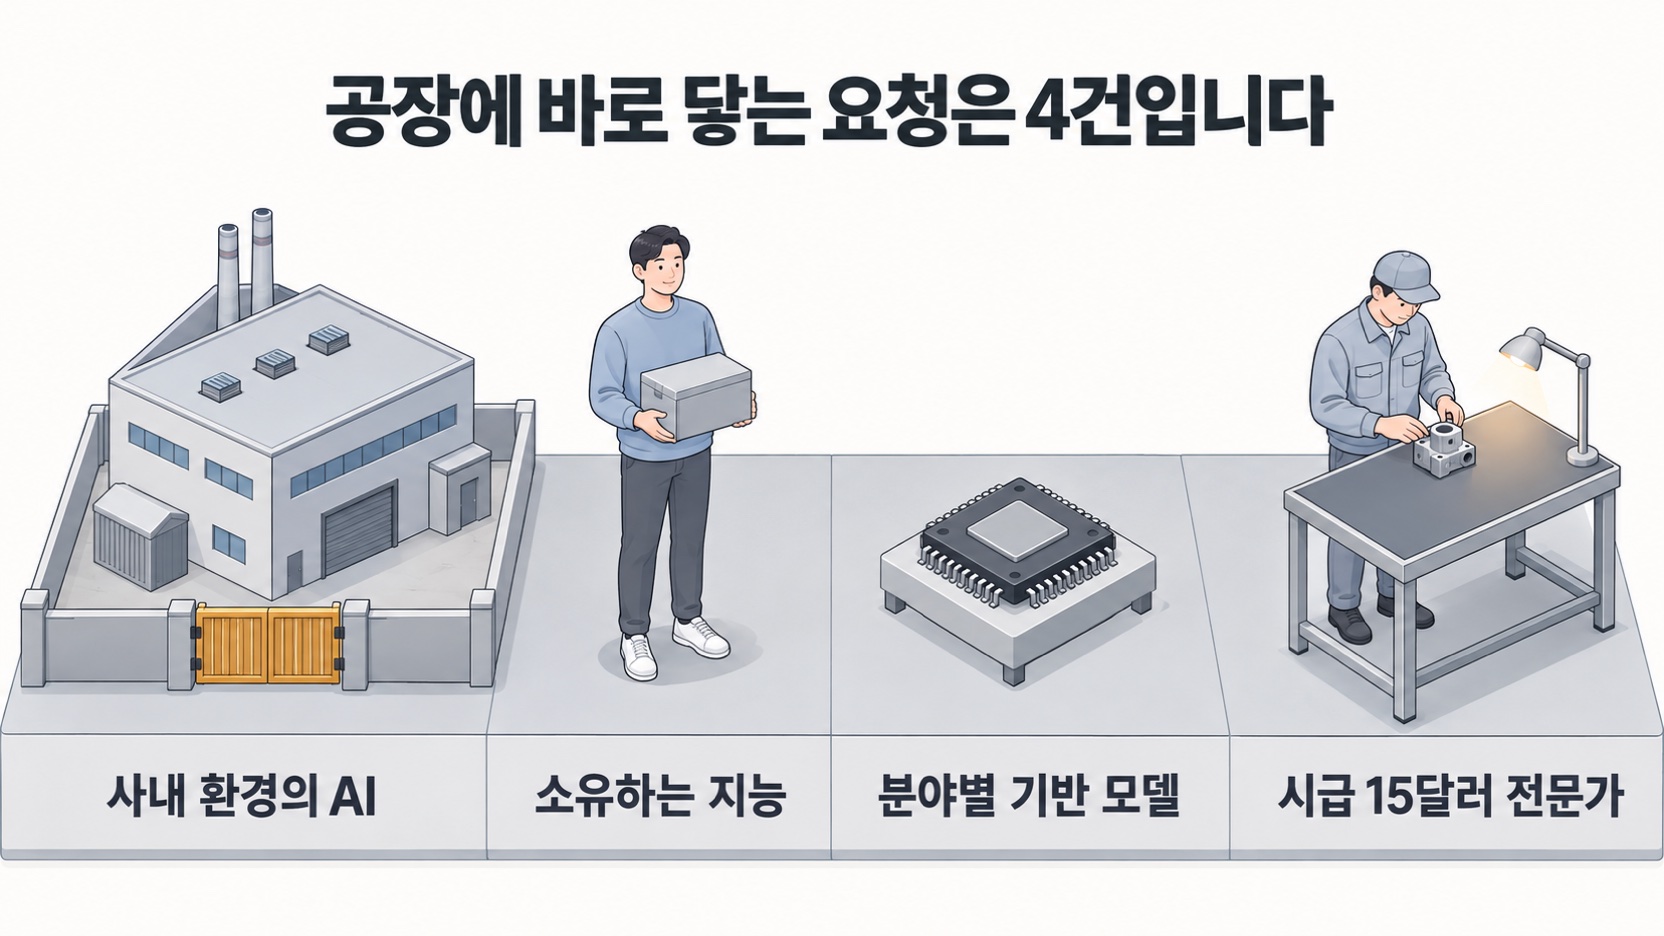
제조 AI 운영체제 VEXPLOR를 만드는 웨이스가 11건을 원문으로 읽어 보니, 공장에 바로 닿는 요청은 4건이었습니다. 인터넷이 끊긴 사내 환경의 AI, 회사가 직접 가진 모델, 제조 특화 기반 모델, 평범한 직원을 전문가로 만드는 AI입니다. 아래에 11건 전체 목록과 공장에 닿는 4건, 그리고 YC 글만 보고 따라가면 안 되는 지점을 차례로 정리합니다.
YC가 올린 요청 11건 가운데 공장에 닿는 것은 4건입니다
11건은 글마다 쓴 사람이 따로 있고, YC의 여섯 명이 나눠 썼습니다. 우주 발사 비용이 100배 이상 떨어진 뒤의 사업부터 글을 잘 쓰는 언어모델, 시청 인허가 업무까지 범위가 넓습니다. 공장에 얼마나 가까운지로 나누면 아래와 같습니다.
· 인터넷이 끊긴 사내 환경의 AI — 가장 값진 데이터는 클라우드 밖에 있다 — 바로 닿음
· 회사가 직접 가진 모델 — 빌려 쓰는 지능과 함께 직접 소유하는 모델이 늘어난다 — 바로 닿음
· 분야별 기반 모델 — 제조·에너지·바이오 특화 모델 — 바로 닿음
· 시급 15달러짜리 전문가 — AI로 평범한 직원을 전문가로 — 바로 닿음
· 미국에서 만드는 로봇 — 모터·감속기·센서 공급망 — 인접
· 물리 인프라 금융 — 로봇·GPU 대출과 리스 — 인접
· 데이터센터 공급망 — 변압기·개폐기·냉각 설비 — 인접
· 그 밖의 4건 — 우주·글쓰기 모델·복지 데이터·시청 AI — 먼 편
인접한 3건도 공장 이야기이긴 합니다. 다만 미국 내 생산 요건이나 금융 상품처럼 공장 운영과는 결이 다릅니다. 아래에서는 바로 닿는 4건만 봅니다.
첫째, 공장 데이터는 인터넷이 끊긴 건물 안에 있습니다
YC의 브래드 플로라는 「세상에서 가장 값진 데이터는 클라우드에 있지 않다」고 썼습니다. 방산 업체와 은행, 병원, 원전은 데이터를 담장 안에 두고 AI API로 보내지 못합니다. YC와 함께 일하는 창업자들이 계속 부딪히는 벽은, 고객이 제품을 좋아하면서도 인터넷 연결 없이 자기 건물 안에서만 돌아가기를 원한다는 점입니다.
공장도 같은 쪽에 있습니다. 설비 데이터와 공정 조건, 불량 이력은 그 공장의 경쟁력이라 밖으로 내보내기를 꺼립니다. 웨이스도 공장에 VEXPLOR를 제안할 때 데이터를 어디에 둘지(공장 안 설치, 웨이스 클라우드, 둘을 나눈 방식)를 제안서 첫 줄에 정합니다. YC는 이 시장이 팔기 느리고 어렵지만 예산이 가장 크고 지키기 쉬운 회사가 나오는 곳이라고 적었습니다. 공장 쪽에서 읽으면 도입 판단이 길어진다는 경고이기도 합니다.
둘째, 지능을 빌려 쓰는 데 그치지 않고 직접 소유하는 회사가 늘어납니다
존 쉬는 AI로 제품을 만드는 거의 모든 회사가 지금은 지능을 빌려 쓴다고 짚었습니다. 큰 연구소에 질문을 보내고 답을 받아 요금을 내는 방식입니다. 그런데 공개된 가중치로 받을 수 있는 오픈 모델이 의미 있는 시험에서 최상위 모델과 견줄 만해졌고, AI가 회사 운영의 한가운데로 들어오면서 모델을 빌려 쓰는 데 따른 의존을 의식하는 회사가 늘었다고 그는 진단합니다. 가장 어려운 문제에는 계속 최상위 모델을 빌려 쓰겠지만, 자기 사업 방식을 담은 특화 모델은 직접 갖는 회사가 많아질 것이라고 봤습니다.
가장 눈여겨볼 대목은 빈자리를 짚은 부분입니다. 오픈 모델을 내려받는 것과 사업을 낫게 만드는 지능을 갖는 것 사이에는 큰 간격이 있고, 누군가는 업무를 평가 세트로, 전문 지식을 학습 데이터로, 운영 중 실패를 개선으로 바꿔 새 기반 모델이 나올 때마다 이어 가야 한다는 것입니다. 공장에 옮기면 「우리 공장에서 이 AI가 맞았는지 무엇으로 판정하느냐」가 먼저 정해져야 모델을 바꾸거나 다듬을 수 있다는 뜻입니다.
셋째, 제조 특화 기반 모델은 가볍고 싸야 합니다
다이애나 후는 제조와 에너지, 바이오 분야에 특화된 기반 모델을 요청했습니다. 기준은 분명합니다. 예시가 없거나 몇 개만 있어도 범용 모델과 같거나 나은 정확도를 내되, 추론 연산은 훨씬 적어서 어디에나 돌릴 수 있을 만큼 싸야 합니다. 어려운 점으로는 분야에 맞고 검증할 수 있는 보상 신호를 얻는 일을 꼽았고, 데이터를 쓸 권리와 기존 전문 모델보다 정확도·연산에서 분명히 앞서는 결과가 필요하다고 덧붙였습니다.
예로 든 모델이 구글의 시계열 예측 모델 TimesFM-3입니다. 3억 3천만 개 파라미터 규모로, 과제별 미세조정 없이 관련된 시계열을 한꺼번에 예측합니다. 예지보전이나 수요 예측을 하는 공장이라면 눈이 가는 예입니다.
넷째, AI는 자격이 병목인 일에 평범한 직원을 세웁니다
브래드 플로라의 다른 글은 AI가 일자리를 없앤다는 이야기의 반대편을 봅니다. 자격증은 없지만 똑똑한 직원을 뽑아 AI로 받쳐 주고, 예전에는 전문가가 해야 했던 일을 맡기는 회사들이 보인다는 것입니다. 그는 지난 산업혁명이 공장 일자리로 중산층을 만들었듯 이번에는 전문가 일자리로 중산층을 만들 수 있다고 썼습니다.
YC가 든 예는 세무와 보험 청구, 이민 서류 같은 사무 업무입니다. 공장으로 옮겨 읽으면 자격 대신 숙련이 병목인 일이 여기에 해당합니다. 품질 원인 분석과 설비 보전, 공정 조건 조정처럼 숙련 엔지니어가 맡던 일이 그렇습니다. 숙련자는 줄고 일은 그대로인 공장에서 이 요청은 먼 미래가 아니라 지금의 인력 문제와 맞닿아 있습니다.
YC가 예로 든 모델을 그대로 공장에 쓰면 안 됩니다
셋째 요청의 예인 TimesFM-3는 가중치가 비상업 라이선스로 공개돼 있습니다. 상업·운영 목적 사용과 미세조정한 파생 모델, 그리고 예측값을 상업 목적으로 쓰는 것까지 막혀 있습니다. 웨이스가 9월에 라이선스 원문을 확인한 결과로, 고객 데이터로 만든 검증 보고서에 그 예측값을 넣는 것도 여기에 걸립니다. 같은 계열의 이전 판(2.5 이하)과 다른 시계열 모델 가운데에는 상업 사용이 열린 라이선스가 있으니, 쓰기 직전에 라이선스 원문을 다시 열어 봐야 합니다.
YC 글 속 미국 규정과 수치도 같은 방식으로 읽어야 합니다. 로봇 국산 부품 비율 요건이나 공급망 점유율은 YC 글쓴이의 주장이고, 국내 공장의 판단 근거로 옮기려면 원출처를 따로 확인해야 합니다. YC는 관심 가는 항목이 있으면 뛰어들 근거로 삼으라고 하면서도, 이 목록이 자기들이 투자하는 분야의 일부일 뿐이라고 적었습니다. 목록에 들었다는 것만으로 시장이 검증된 것은 아닙니다.
공장이 이 흐름에서 먼저 확인할 것은 3가지입니다
YC의 4가지 요청을 공장 쪽 질문으로 바꾸면 아래와 같습니다.
· 데이터가 건물 밖으로 나가는가 — 사내 설치가 가능해야 도입 논의가 시작됩니다 — 사내 환경의 AI
· 맞았는지 무엇으로 판정하는가 — 공장별 평가 세트가 있어야 모델을 바꿀 수 있습니다 — 소유하는 지능
· 쓰려는 모델의 라이선스가 상업 사용을 허락하는가 — 예측값까지 묶는 라이선스가 있습니다 — 분야별 기반 모델
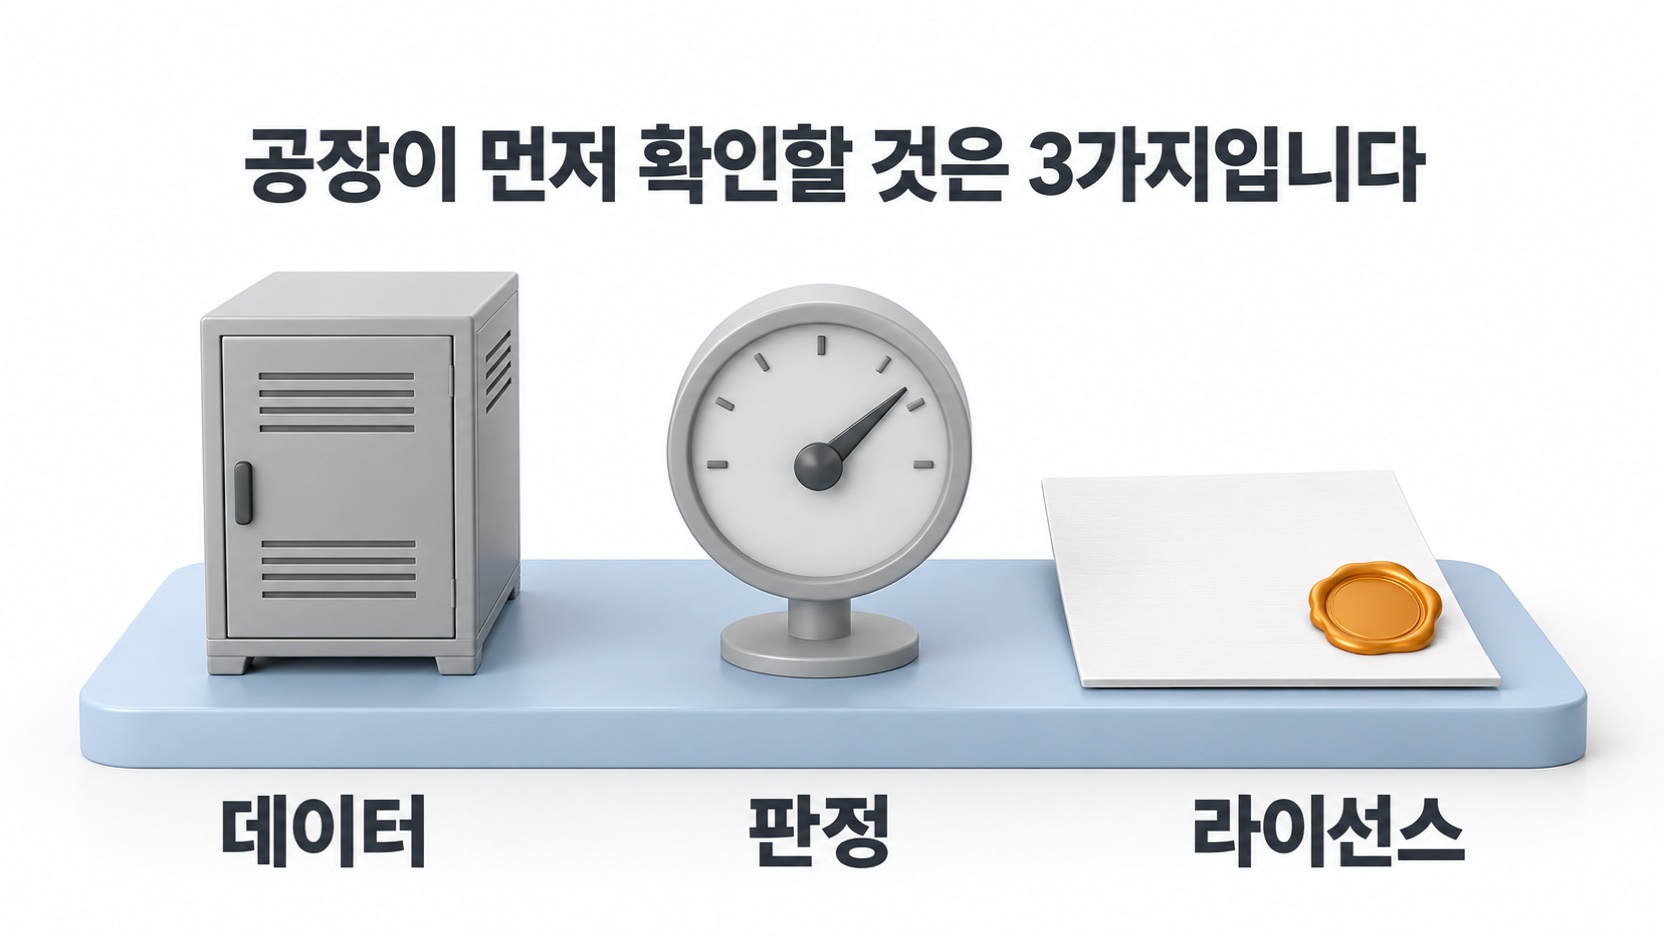
세 가지 모두 모델의 성능 점수보다 앞에 오는 질문입니다. 웨이스가 VEXPLOR를 제안할 때도 데이터를 둘 자리와 공장별 판정 기준을 제안서에 먼저 적고, 모델은 실측을 거친 뒤에 정합니다.
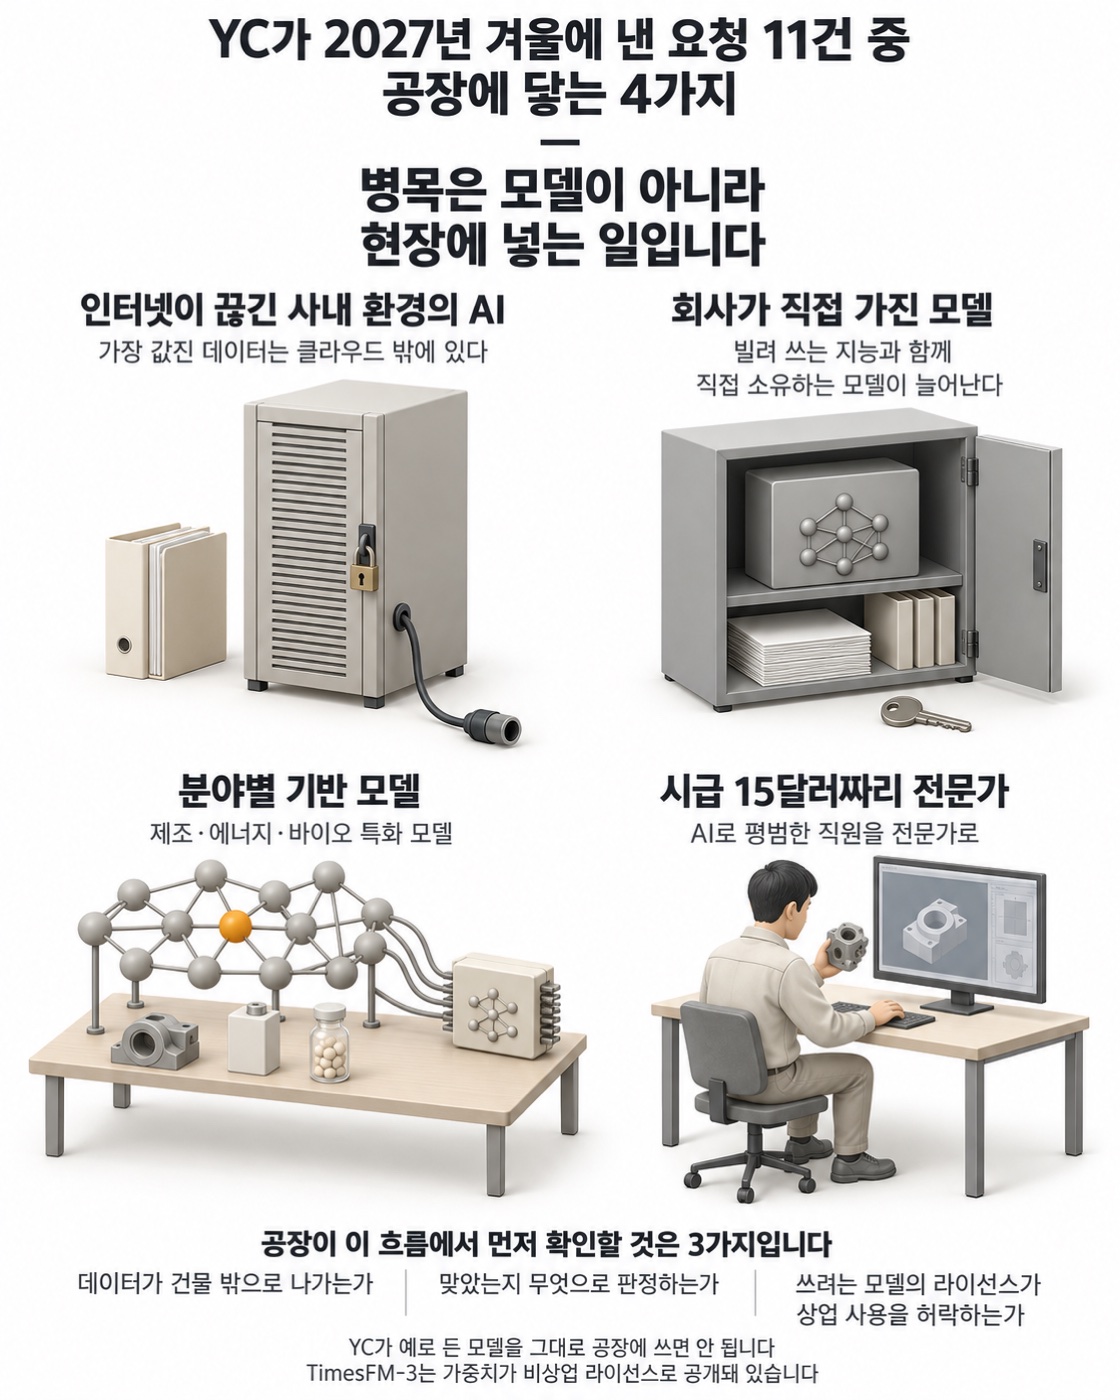
YC가 이번에 짚은 병목은 더 좋은 모델이 아니라 그 모델을 공장 같은 현장에 넣는 일입니다. 공장 쪽에서 준비할 것도 모델 고르기보다 데이터를 어디에 두고 결과를 무엇으로 판정할지 정하는 일입니다.
(이 글은 웨이스 기술블로그에 먼저 실린 글입니다. 원문: https://blog.vexplor.com/post/yc-rfs-winter-2027-factory-ai?utm_source=eo&utm_medium=social&utm_campaign=2026-11-03)