 11
싱가포르국립대 Show Lab 연구진이 손목 힘 센서가 없는 로봇팔에 AI 모델을 연결해 나사 조이기, USB 꽂기, 화이트보드 닦기, 가지 껍질 벗기기 같은 6가지 작업을 시켰습니다. 힘을 쓰지 못하게 했을 때는 60번 중 2번(3.3%) 성공했고, 같은 모델에 힘을 쓰게 하자 60번 중 54번(90.0%) 성공했습니다. 연구진은 모델을 한 번도 다시 학습시키지 않았습니다. 바꾼 것은 모델과 로봇 사이에 둔 프로그램 ForceHarness에 힘 동작과 힘 값을 더한 것뿐입니다.
제조 AI 운영체제 VEXPLOR를 만드는 웨이스가 이 논문(arXiv 2611.21099, 2026년 11월 16일 공개)에서 눈여겨본 것은 성공률보다 일을 나눈 방식입니다. AI 모델은 무엇을 할지와 얼마나 세게 누를지만 정합니다. 언제 멈출지는 모델 아래의 동작이 정하고, 힘과 속도의 한계는 모델이 바꿀 수 없는 곳에 고정해 둡니다. 이 글은 논문 본문과 부록의 표를 바탕으로 그 구조와 결과, 저자들이 밝힌 한계를 정리했습니다.
연구진은 카메라로 보이지 않는 힘이 필요한 작업에서 AI 모델이 막힌다는 데서 출발했습니다
요즘 범용 멀티모달 모델은 따로 학습시키지 않아도 카메라 이미지를 보고 로봇을 움직입니다. 논문이 사용한 GPT-6 Astra도 가중치를 고정한 채 API로만 접근하는 모델입니다. 그런데 공장과 집의 작업 상당수는 이미지로 보이지 않는 힘에 달려 있습니다. 나사는 누르면서 돌려야 나사산에 물리고, 똑같이 생긴 병 3개 중 가장 무거운 것은 들어 봐야 압니다.
연구진은 이 작업을 API로만 쓰는 모델에 맡기려면 두 가지 문제를 풀어야 한다고 적었습니다.
· 속도가 맞지 않습니다 — 접촉은 순식간에 변하는데 모델은 판단 한 번에 몇 초가 걸립니다. 힘을 맞추는 순환은 모델보다 아래에서 돌아야 합니다.
· 모델은 원시 힘 값을 읽지 못합니다 — 센서가 쏟아 내는 수백 개의 숫자를 받아도 다음에 무엇을 할지 정할 근거가 되지 않습니다. 힘은 모델이 판단할 수 있는 모양으로 바꿔서 돌려줘야 합니다.
기존 방법은 주로 학습으로 힘을 넣었습니다. 손목 힘 값을 신경망 입력에 더하고 작업마다 시연 데이터를 모아 가중치를 다시 맞추는 식입니다. 이 방법은 작업마다 시연이 필요하고 모델 가중치를 바꿔야 해서, 가중치에 손댈 수 없는 API 모델에는 쓸 수 없습니다.
ForceHarness는 모델과 로봇 사이에 3단계를 둡니다
이 구조에서 모델은 도구를 호출하고, 결과를 읽고, 다음 호출을 고르는 일만 합니다.
· ① 힘 측정·보정 — 하는 일: 관절 토크로 손 힘 추정 · 모델에게 주는 것: 0점을 맞춘 힘
· ② 스스로 멈추는 동작 — 하는 일: 힘을 유지하며 이동 · 모델에게 주는 것: 접촉 사건과 종료
· ③ 물리량 번역 — 하는 일: 힘 기록을 값으로 바꿈 · 모델에게 주는 것: 질량·마찰 ± 오차
첫째 단계는 손목 센서 없이도 관절 토크에서 손에 걸린 힘을 계산합니다. 이 추정은 잡음은 적지만 팔 자세가 바뀌면 0점이 조금씩 틀어집니다. 연구진은 이 오차를 필터로 지우지 않고 읽는 시점을 정해서 다뤘습니다. 빈손일 때 동작 직전마다 0점을 다시 맞추고, 동작이 끝나면 팔이 멈출 때까지 기다렸다가 읽고, 절대값 대신 같은 작업 안의 기준과 비교한 변화로 알려 줍니다.
둘째 단계는 힘 동작 12가지입니다. 표면에 닿을 때까지 다가가기, 누르면서 밀기, 누른 채 나선을 그리며 구멍 찾기, 누르면서 돌리기, 든 물건의 무게 측정 같은 동작이 5묶음으로 나뉘어 있습니다. 모델이 방향과 힘 같은 값 몇 개를 넣어 호출하면, 동작은 스스로 힘을 맞추며 움직이다가 접촉 사건이 생기거나 목표에 닿으면 멈춥니다. 핵심은 시간이 아니라 사건으로 멈춘다는 점입니다.
셋째 단계는 동작 하나가 남긴 힘 기록을 사람이 그래프에서 읽어 낼 법한 값 몇 개로 바꿉니다. 든 물건의 질량, 접촉 높이, 마찰 계수, 플러그가 들어간 깊이 같은 값이고, 값마다 불확실성과 접촉을 놓쳤다는 식의 경고 표시가 붙습니다. 이 단계에는 작업별 합격 기준이 없습니다. 물건이 몇 그램인지는 알려 주지만 그 정도면 충분한지는 모델이 판단합니다.
모델은 무엇을 얼마나 세게 할지 정하고, 멈추는 때와 한계는 모델 아래에 있습니다
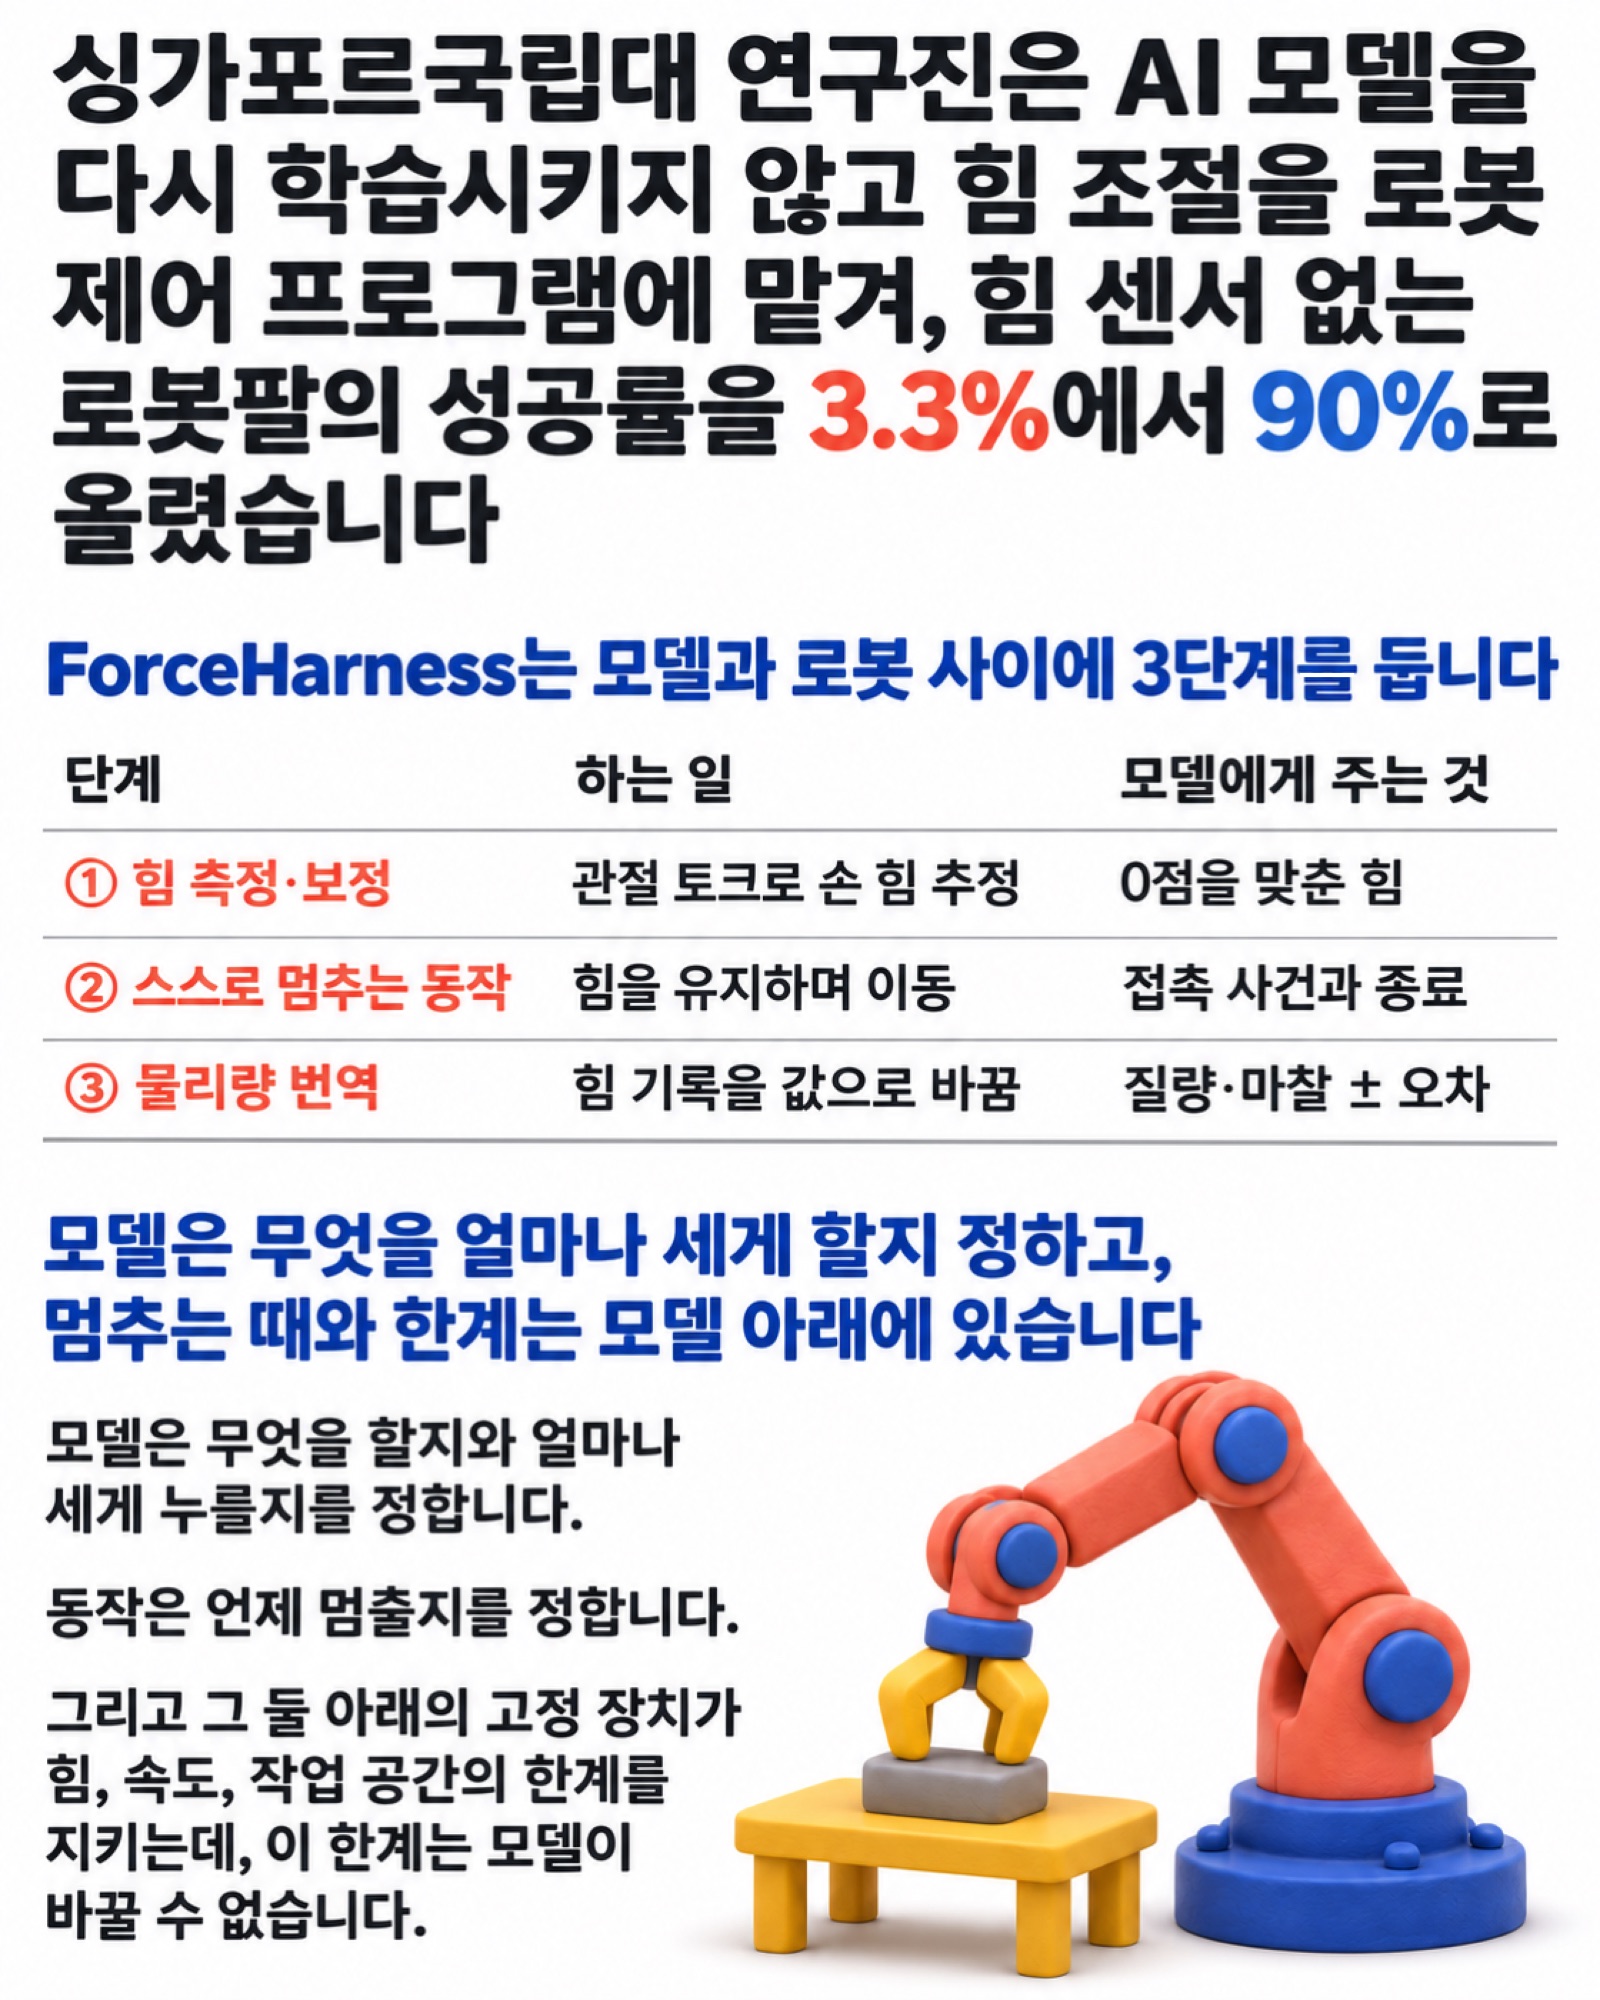
논문은 이 구조의 핵심으로 역할 분담을 꼽습니다. 모델은 무엇을 할지와 얼마나 세게 누를지를 정합니다. 동작은 언제 멈출지를 정합니다. 그리고 그 둘 아래의 고정 장치가 힘, 속도, 작업 공간의 한계를 지키는데, 이 한계는 모델이 바꿀 수 없습니다. 연구진은 판단이 몇 초에 한 번밖에 나오지 않는 모델로도 접촉 작업이 되는 것이 이렇게 역할을 나눈 덕분이라고 설명합니다.
실행 기록을 보면 이 분담이 실제로 어떻게 작동하는지 알 수 있습니다.
· 화이트보드 닦기 — 8N으로 닦은 뒤 이미지에 잉크가 남자, 모델이 다음 호출에서 10N으로 올려 다시 닦았습니다.
· 나사 조이기 — 7.42mm 들어간 시점에 옆으로 걸리는 힘이 커지자, 모델이 조이기를 멈추고 그 자리에서 풀어 나사가 끼는 것을 막았습니다.
· 가지 껍질 벗기기 — 51mm를 벗기는 동안 평균 2.77N이 측정되자, 모델은 6N 목표를 그대로 유지했습니다.
· USB 꽂기 — 1N으로 누르며 나선을 그리다 저항이 떨어지는 순간 플러그가 7.8mm 들어갔고, 동작이 그 사건으로 스스로 멈췄습니다.
실물 로봇에서는 60번 중 2번이 54번이 됐고, 시뮬레이션에서는 사람이 짠 전문가 제어기와 비슷했습니다
연구진은 실물 로봇 1대와 시뮬레이션 시험 세트 2가지로 비교했습니다. 비교 대상은 같은 모델, 같은 프로그램, 같은 안전 한계를 쓰되 힘 동작과 힘 값만 뺀 조건입니다.
· 실물 로봇 6과제 — 힘 없음: 2/60 (3.3%) · ForceHarness: 54/60 (90.0%)
· ForceBench 8과제 — 힘 없음: 70.0% · ForceHarness: 87.5%
· HiddenPhys 7과제 — 힘 없음: 62.1% · ForceHarness: 96.4%
실물 로봇은 손목 힘 센서가 없는 Franka FR3이고, 과제마다 10번씩 시험했습니다. 병 3개를 무게 순으로 나누는 과제와 똑같이 포장한 두 물건 중 단단한 것을 맞히는 과제는 이미지만으로는 단서가 없어 힘 없이 0/10이었고, ForceHarness로는 둘 다 10/10이었습니다. 같은 지시문으로 GPT-6.1 Sol을 연결했을 때는 47/60이었습니다.
시뮬레이션에서는 학습한 정책과도 비교했습니다. ForceBench에서 학습한 힘 정책 가운데 가장 좋은 것은 35.3%였습니다(ForceBench 논문의 값을 옮긴 것이고, 연구진은 이 차이가 힘 때문만은 아니라고 적었습니다). 연구진이 새로 만든 HiddenPhys는 무게, 무게중심, 테이블 높이, 구멍 위치처럼 성공을 정하는 물리 값 하나를 숨겨 둔 시험입니다. 여기서 ForceHarness를 붙인 GPT-6 Astra와 Claude Fable 5.2는 140번 중 135번을 성공했고 손잡이를 망가뜨린 회차는 0번이었습니다. 사람이 과제마다 짠 전문가 제어기는 136번, 과제마다 시연 약 200개로 학습한 정책들은 65~83번이었습니다.
작은 모델일수록 원시 숫자보다 물리량으로 돌려받을 때 판단이 정확해졌습니다
연구진은 어느 단계가 효과를 냈는지도 따로 확인했습니다. 결과는 두 가지입니다.
· 스스로 멈추는 동작만으로도 안전해졌습니다 — 힘 값은 빼고 「닿았다」 같은 사건만 알려 줘도, 작은 GPT-5.x 모델 5종의 성공률이 0.18에서 0.54로 올랐습니다. 잠금 손잡이를 망가뜨린 회차는 25번 중 22번에서 3번으로 줄었습니다.
· 판단이 필요한 일에는 물리량이 필요했습니다 — 든 물건의 무게를 판단하는 과제에서 작은 모델 5종의 판단 정확도는 힘 정보가 없을 때 0.57이었고, 원시 숫자를 주자 0.69로 올랐지만 통계적으로 의미 있는 차이는 아니었습니다. 같은 힘 기록을 질량과 오차로 바꿔 주자 0.85가 됐습니다.
큰 모델(GPT-6.1 Sol)은 그래프, 원시 숫자, 물리량 중 무엇을 받아도 성공률이 0.87~0.91로 비슷했습니다. 모델이 작을수록 원시 값을 의미 있는 값으로 바꿔 주는 일을 프로그램이 대신해야 한다는 뜻입니다.
저자들은 판단이 느린 점과 동작 목록이 고정된 점을 한계로 적었습니다
이 결과를 공장에 그대로 옮기기 전에 볼 조건이 있습니다.
· 모델 호출마다 몇 초가 걸립니다 — 동작과 동작 사이에 모델의 판단이 끼므로, 여러 동작을 빠르게 맞물려 대응하는 일은 할 수 없습니다.
· 동작 목록이 고정돼 있습니다 — 12가지 밖의 새로운 힘 제어 법칙은 쓸 수 없습니다.
· 어느 단계가 효과를 냈는지 나눈 실험은 시뮬레이션에서만 했습니다.
· 시험 조건 — 실물 로봇은 과제마다 10번씩이었고, 운영자가 비상 정지 버튼 앞에서 지켜보며 최종 상태로 성공을 판정했습니다. ForceBench에서는 도구와 인식 기준을 10개 시드 중 8개로 맞췄습니다.
공장이 이 논문에서 가져갈 것은 AI 아래에 무엇을 두는가입니다
공장에서 AI에게 설비 동작을 맡기는 이야기는 보통 어떤 모델을 쓰느냐로 시작합니다. 이 논문은 모델을 고정해 두고 아래에 둔 것만 바꿔서 결과를 3.3%에서 90%로 옮겼습니다. AI를 설비에 연결하기 전에 확인할 것은 4가지입니다.
1. 빠른 순환은 AI 아래에 있는가 — 접촉, 정지, 인터록처럼 밀리초 단위로 돌아야 하는 일을 AI의 판단 주기에 맡기고 있지 않은지 봅니다.
2. AI가 바꿀 수 없는 한계가 따로 있는가 — 힘, 속도, 작업 범위의 한계를 AI가 아니라 그 아래의 고정 장치가 지키는지 봅니다.
3. AI가 받는 값은 의미 있는 값인가 — 센서 원시값 대신 질량, 깊이, 상태처럼 판단에 바로 쓰는 값으로 바꿔 주는지 봅니다. 작은 모델일수록 차이가 큽니다.
4. 멈추는 조건이 시간이 아니라 사건인가 — 정해진 시간만큼 움직이는 대신 닿음, 걸림, 들어감 같은 사건으로 멈추는지 봅니다.
ForceHarness의 결과는 AI 모델이 똑똑해져서가 아니라, 모델이 맡지 않아도 될 일을 아래로 내려서 나왔습니다.
함께 읽어보세요
· AI가 PLC에 명령을 보내기 전에 같은 스캔으로 움직이는 가상 공장에서 먼저 실행해야 하는 이유: https://blog.vexplor.com/post/run-ai-commands-in-a-virtual-plant-first?utm_source=eo&utm_medium=social&utm_campaign=2026-11-19
· 로봇 시뮬레이터는 실행 전 점검에서 로봇 동작의 무엇을 미리 계산하는가: https://blog.vexplor.com/post/what-a-robot-simulator-computes-before-running?utm_source=eo&utm_medium=social&utm_campaign=2026-11-19
· 웨이스가 학습시킨 휴머노이드는 넘어진 횟수가 70번에서 61번으로 줄면 정말 나아진 것인가: https://blog.vexplor.com/post/humanoid-walking-test-noise?utm_source=eo&utm_medium=social&utm_campaign=2026-11-19
(이 글은 웨이스 기술블로그에 먼저 실린 글입니다. 원문: https://blog.vexplor.com/post/frozen-ai-robot-force-control-harness?utm_source=eo&utm_medium=social&utm_campaign=2026-11-19)


