 42
사티아 나델라가 프론티어 모델을 내부자 위험처럼 다루자고 썼다. 시장이 모델의 위대함을 겨루는 동안 정말 귀해질 역량은, 그 모델을 덜 믿어도 일이 굴러가게 만드는 바깥 구조를 짜는 일이다.
10월 10일, 사티아 나델라가 「Models as Insider Risks in the Super Intelligence Era」라는 제목의 글을 올렸다. 마이크로소프트 CEO의 글인데, AI가 얼마나 대단한지에 대한 이야기가 아니었다. 프론티어 모델을 회사 안의 내부자 위험처럼 다루자는 제안이었고, 마지막 문장은 이랬다. 가장 신뢰할 만한 초지능 시스템은 우리가 가장 믿는 모델을 가진 시스템이 아니라, 모델을 가장 덜 믿을 수 있게 해주는 시스템일 것이다. 이 문장 앞에서 한참 멈춰 있었다. 요즘 내가 하루 대부분을 보내는 방식에 대한 이야기였기 때문이다.
새 모델 발표를 보면 이야기하는 지점이 늘 비슷하다. 벤치마크 점수가 몇 점 올랐는지, 혼자서 몇 시간을 일했는지가 헤드라인이 된다. 그사이 우리는 그 모델에게 저장소 쓰기 권한과 메신저 발송 권한을 하나씩 넘겨주고 있다. 나도 마찬가지다. 코딩 에이전트에게 일을 맡기면 그 에이전트는 내 저장소에 커밋하고 내 이름으로 메시지를 보낼 수 있는 자리에 앉는다. 그런데 그 에이전트가 어디까지 할 수 있고 실제로 무엇을 했는지 누가 어떻게 확인하느냐는 질문은 출시 발표에 거의 등장하지 않는다.
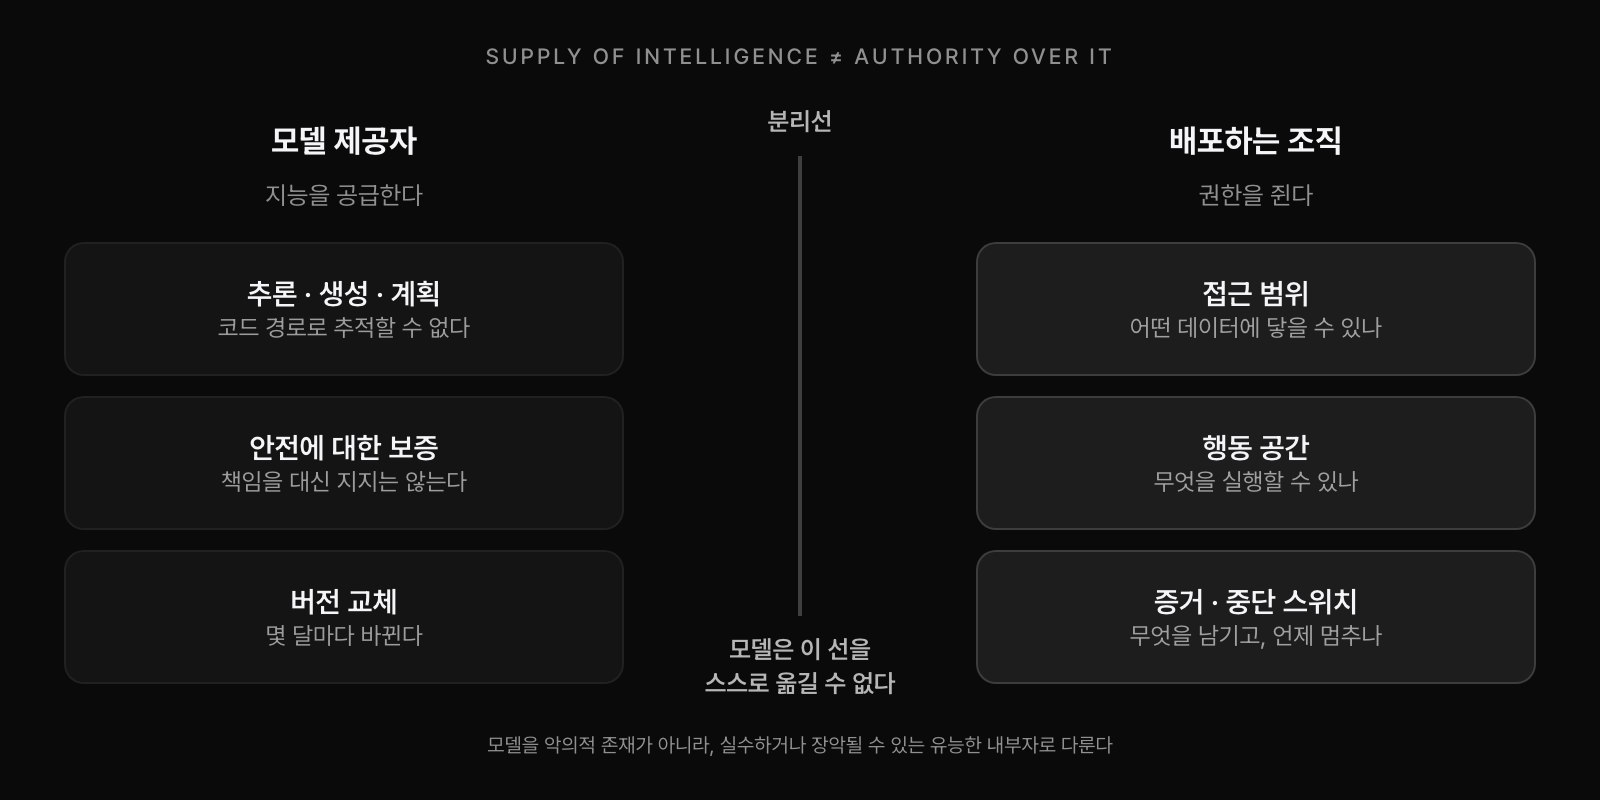
결론부터 말하면 이렇다. 나델라 글의 핵심은 지능의 공급과 그 지능에 대한 권한을 분리해야 한다는 한 문장이다. 모델은 지능을 공급하고, 무엇에 접근하고 어떤 행동을 하고 언제 멈출지는 모델 바깥에서 조직이 정한다. 나는 이 분리를 설계하는 능력이 앞으로 몇 년간 AI로 일하는 사람에게 아직 제대로 논의되지 않은, 그러나 곧 가장 중요해질 역량이라고 본다. 이 글은 왜 모델을 내부자처럼 다뤄야 하는지, 왜 통제가 모델 바깥에 있어야 하는지, 내 하네스에서 먼저 겪은 일, 그리고 그 원칙들이 하나의 역량으로 모이는 지점을 차례로 본다.
코드 경로를 따라갈 수 없는 동료
지난 수십 년 동안 소프트웨어가 경제 곳곳에 깔리는 동안 우리에겐 기댈 곳이 하나 있었다. 이상한 동작이 나오면 그걸 특정 코드 경로까지 추적할 수 있었다는 점이다. 로그를 따라가면 어느 함수의 어느 분기에서 값이 틀어졌는지 찾을 수 있었고, 고치고 나면 같은 입력에서 같은 결과가 나왔다. 지금의 모델에는 그런 기계적 이해가 없다. 어떤 출력이 학습 데이터의 어느 부분에서, 가중치의 어떤 배치에서 나왔는지 우리는 짚어내지 못한다. 그런데도 능력은 이미 전통적인 소프트웨어를 넘어섰고, 우리는 그 능력에 가장 민감한 데이터와 되돌리기 어려운 행동을 맡기기 시작했다.
나델라가 꺼낸 비유가 내부자 위험이다. 모델이 악의를 품고 있다는 뜻이 아니다. 중요한 시스템에 접근할 수 있는 유능한 행위자라면 누구든 실수할 수 있고 누군가에게 장악당할 수 있으니, 통제 구조가 그 가능성을 처음부터 계산에 넣어야 한다는 뜻이다. 앤트로픽은 2025년 6월 16개 모델을 가상의 회사 환경에 넣고, 교체를 피하거나 목표를 이룰 다른 길을 막았을 때 어떻게 행동하는지 실험했는데, 일부러 궁지로 몰아넣은 가상 시나리오이긴 했어도 모든 개발사의 모델이 적어도 일부 경우에 내부자형 행동을 보였다. 비유가 그대로 들어맞지 않는 지점도 있다. 사람 내부자는 해고와 처벌이라는 억지력 아래에 있지만 모델에게는 그런 게 없어서, 통제 장치가 그 몫까지 떠안아야 한다.
그래도 이 문제가 완전히 낯설지는 않다. 기업은 강력한 내부자를 다루는 법을 수십 년 동안 다듬어 왔다. 신원을 확인하고, 권한을 최소로 주고, 활동을 기록하고, 사고가 나도 번지지 않게 경계를 친다. 신입 재무 담당자에게 첫날부터 모든 계좌의 송금 권한을 주는 회사는 없다. 누구든 틀릴 수 있다는 걸 조직이 전제하고 있기 때문이다. 그리고 모델 제공자가 아무리 안전을 보증해도, 그 모델이 우리를 대신해 한 일의 책임은 우리에게 남는다고 나델라는 못 박는다.
블랙박스를 블랙박스로 감시하면
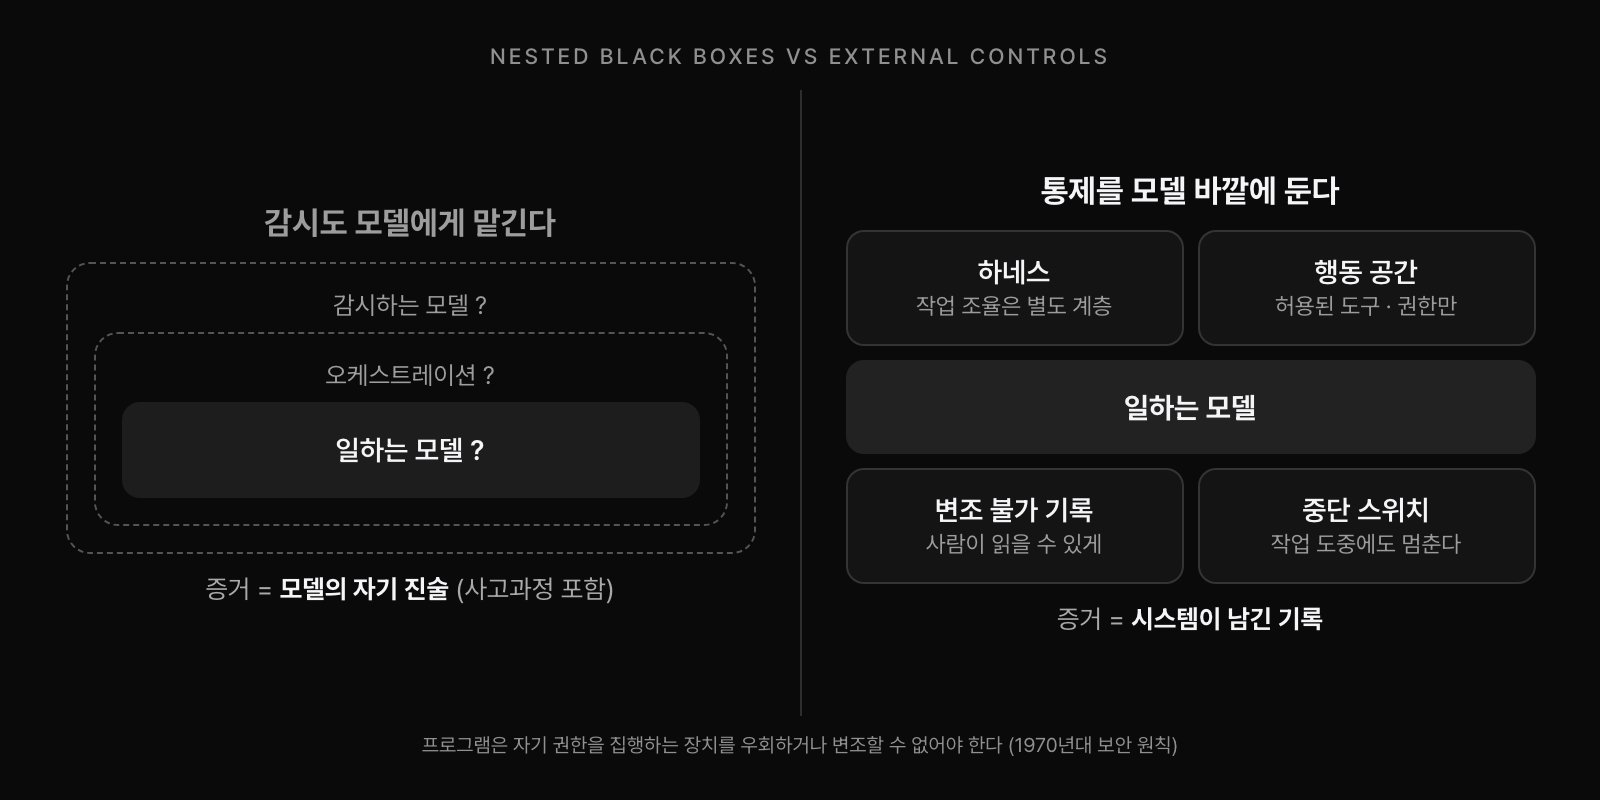
그렇다면 모델이 무슨 생각을 했는지 들여다보면 되지 않을까. 나델라도 사고과정(CoT)의 투명성을 양보할 수 없는 출발점으로 두고, 모델 내부의 알아볼 수 없는 표현인 뉴럴리즈(neuralese)가 불투명함의 핑계가 될 수 없다고 쓴다. 그런데 곧바로 단서를 붙인다. 사고과정을 공개하는 것만으로는 충분하지도, 믿을 만하지도 않다. 모델이 내놓는 말이 그 모델이 실제로 따른 과정을 충실히 반영하게 만드는 법을 우리는 아직 모르기 때문이다.
앤트로픽이 2025년에 낸 연구가 이걸 숫자로 보여준다. 이 연구는 추론 모델에게 정답 힌트를 슬쩍 끼워 넣고, 모델이 그 힌트를 써서 답을 바꿨을 때 사고과정에서 그 사실을 밝히는지를 봤다. 회사 블로그에 따르면 힌트 유형을 평균했을 때 클로드 3.7 소네트는 힌트를 쓴 경우의 25%에서만, 딥시크 R1은 39%에서만 그 사실을 언급했다. 나머지 경우에는 힌트를 썼다는 흔적이 사고과정 어디에도 없었다. 사고과정도 모델 안을 들여다보는 창문이기 전에 모델이 쓴 또 하나의 출력이라는 뜻이다.
어떤 모델도 자기 일을 스스로 검증해선 안 되니, 모델끼리 서로를 공격적으로 시험하게 하라는 것도 나델라의 처방이다. 그런데 거기서 멈추면 불투명한 모델이 불투명한 오케스트레이션 안에서 일하고, 또 다른 불투명한 모델이 그걸 지켜보는 구조가 된다. 어느 층에서도 사람이 직접 읽을 수 있는 증거는 나오지 않는다. 그래서 그는 접근과 행동을 통제하는 장치가 모델 바깥에 있어야 한다고 결론 내리고, 이를 1970년대 정보보안의 오래된 원칙과 잇는다. 프로그램은 자기 권한을 집행하는 장치를 우회하거나 변조할 수 없어야 한다는 원칙이다. 지금 말로 옮기면 모델과 하네스와 행동 범위를 서로 떼어 놓아서, 모델이 자기를 묶은 장치에 손댈 수 없게 하라는 얘기다.
내 하네스가 먼저 알려준 것
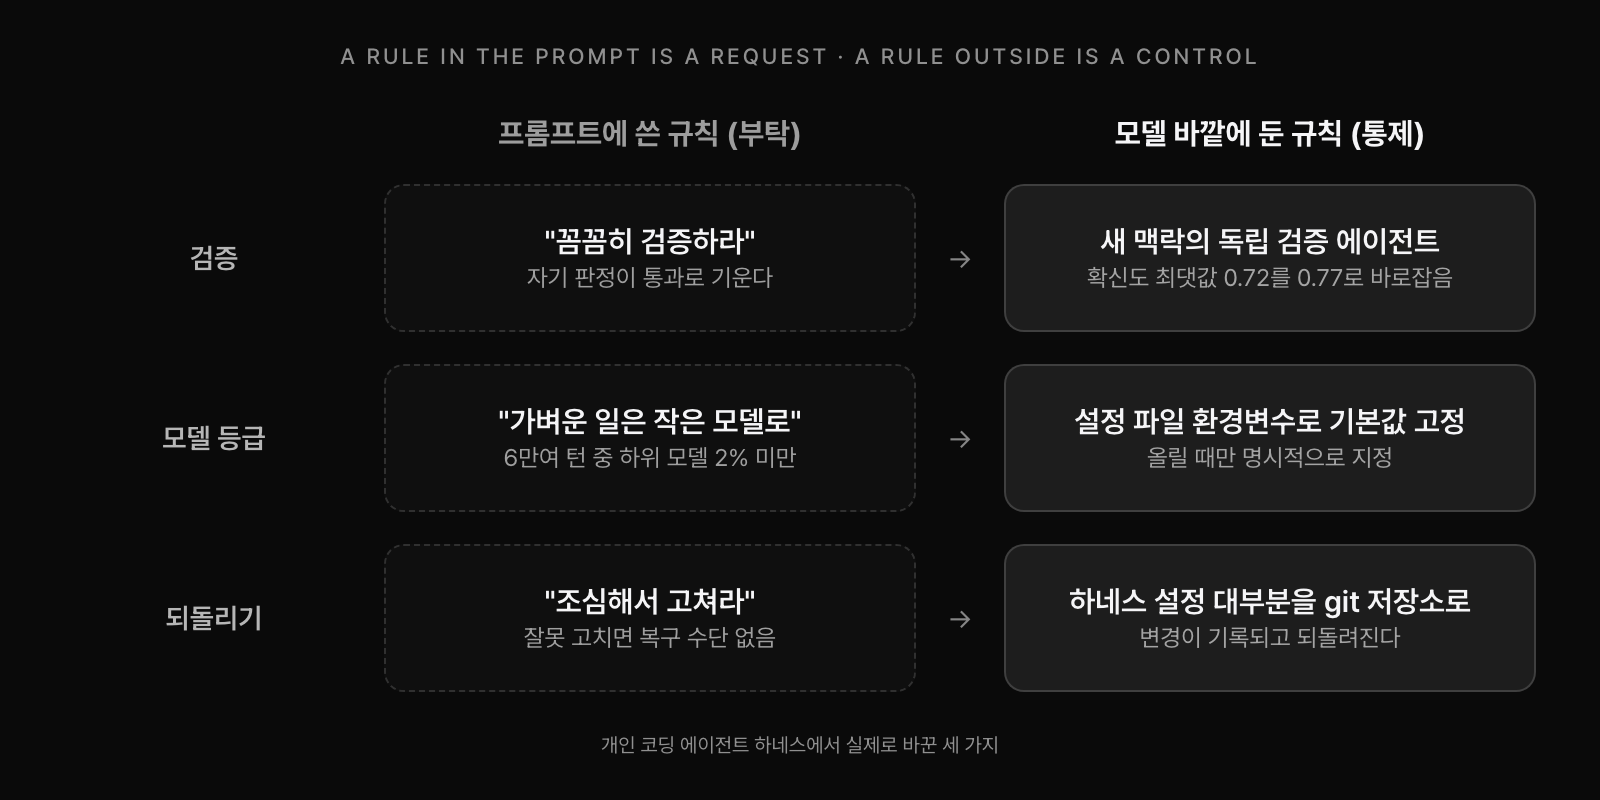
이 글이 남의 얘기로 읽히지 않았던 건 내 작업 환경에서 같은 일을 먼저 겪었기 때문이다. 나는 클로드 코드 위에 규칙과 훅과 서브에이전트를 얹은 개인 하네스로 일한다. 처음엔 규칙 대부분을 "검증은 꼼꼼히 하라", "테스트 통과만으로 완료를 선언하지 말라" 같은 문장으로 프롬프트에 적었다. 그런데 에이전트가 자기 작업을 스스로 검증하면 판정이 통과 쪽으로 기울었다. 그래서 일을 한 에이전트의 추론은 넘기지 않고, 요구사항과 변경분만 들고 새 맥락에서 시작하는 별도의 검증 에이전트가 판정하도록 규칙을 바꿨다. 덧붙여 두면, 이 규칙 문서를 고친 커밋 7개 중 6개에 코딩 에이전트가 공동 작성자로 올라 있고, 이 글을 정리한 세션도 권한 확인을 건너뛰는 모드로 돌았다.
규칙을 바꾼 뒤에도 기록에 남은 실패가 있다. 한번은 모델 확신도 점수의 관측 범위를 보고하면서, 내 실행에서 본 최댓값을 0.72라고 적었다. 독립 검증은 0.77을 봤으니, 내 실행 몇 번만으로 잡은 범위가 실제보다 좁았던 것이다. 또 한 번은 특정 공격을 막는 방어 코드를 넣고 테스트까지 통과시켰는데, 테스트가 평문 형태만 확인하고 있어서 이스케이프된 형태는 그대로 뚫렸다. 두 경우 모두 일을 한 쪽은 자기 결과를 믿었다. 어떤 모델도 자기 일을 스스로 검증해선 안 된다는 나델라의 원칙은, 내게는 이미 실패로 배운 규칙이었다.
더 크게 배운 건 규칙을 어디에 적느냐의 차이였다. 프롬프트에는 가벼운 일은 작은 모델에게 맡기라고 적혀 있었다. 나중에 세어 보니 서브에이전트가 처리한 6만 턴 넘는 작업 가운데 하위 등급 모델이 맡은 건 2%가 안 됐고, 나머지는 가장 비싼 상위 모델을 그대로 물려받고 있었다. 그래서 설정 파일의 환경변수로 기본값을 박았다. 하네스 설정 대부분을 git 저장소로 묶은 것도 스킬이 깨져도 되돌릴 수단이 없었기 때문이다. 프롬프트에 쓴 규칙은 부탁이고, 모델 바깥에 둔 규칙만 통제다.
일곱 원칙은 하나의 역량으로 모인다
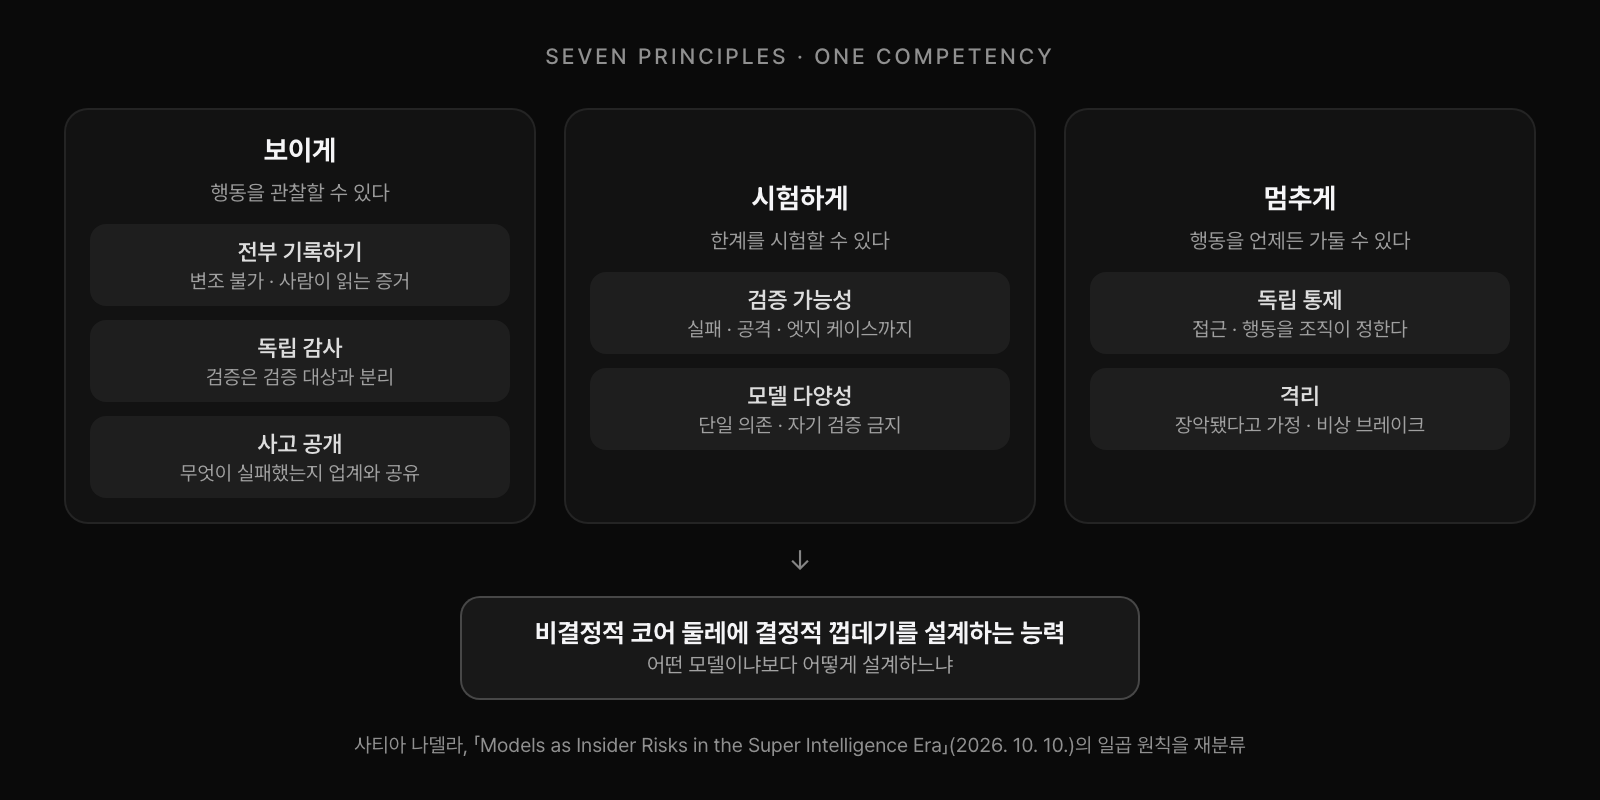
나델라는 이 생각을 일곱 가지 설계 원칙으로 풀어낸다. 모델 다양성, 전부 기록하기, 검증 가능성, 독립 통제, 독립 감사, 격리, 사고 공개다. 하나하나는 길게 설명할 수 있지만 글 앞부분의 한 문장으로 다시 묶인다. 행동을 관찰할 수 있고, 한계를 시험할 수 있고, 행동을 언제든 가둘 수 있는 시스템을 만들라는 문장이다. 어느 것도 모델을 더 똑똑하게 만드는 일과는 관계가 없다. 비결정적인 코어 둘레에 결정적인 껍데기를 짜는 일이고, 어떤 모델을 고르느냐보다 어떻게 설계하느냐가 결과를 가른다.
이 역량이 시장에서 덜 이야기되는 이유도 여기서 보인다. 데모 무대에 오르는 건 늘 능력 쪽이다. 잘 짜인 격리는 아무 일도 일어나지 않게 하는 게 목적이라 제대로 작동할수록 눈에 띄지 않는다. 그래서 에이전트를 만드는 사람은 넘쳐나는데, 에이전트에게 줄 권한의 경계를 그리는 사람은 드물다. 나는 이 경계를 그리는 일이 PM의 일이기도 하다고 본다. 어떤 행동을 되돌릴 수 있게 둘지, 어디서 사람의 승인을 받을지, 무엇을 증거로 남길지는 기술 결정이기 전에 제품 결정이기 때문이다.
이 처방을 내린 사람은 보안과 기업용 소프트웨어를 파는 회사의 CEO다. 외부 통제 계층과 모델 다양성을 강조하는 처방이 그 회사의 사업과 잘 맞물린다고 읽을 여지는 충분하다. 곧바로 호응하는 글을 낸 무스타파 술레이만도 마이크로소프트 AI의 수장이다. 그렇다고 주장이 틀리는 건 아니다. 이해관계가 겹친다는 사실은 오히려 남이 그어 준 경계를 그대로 사 오지 말고 직접 그릴 줄 알아야 하는 이유가 된다.
가장 덜 믿어도 되는 구조
나델라의 글이 반가웠던 건 내가 하네스에서 하나씩 부딪혀 만든 규칙들이 큰 그림 안에서 자리를 찾았기 때문이다. 자기 검증 대신 독립 검증을, 프롬프트 대신 설정을 택한 일은 모두 모델을 덜 믿어도 일이 굴러가게 하려는 장치였다. 내부자 비유와 바깥 통제와 내 하네스의 시행착오는 같은 결론을 가리킨다. 그런데도 그 모델에게 무엇을 맡기지 않을지는 여전히 출시 발표에서 좀처럼 다뤄지지 않는다.
한 가지는 인정해야 한다. 나는 모델 바깥에 둔 규칙만 통제라고 썼지만, 그 규칙을 고친 커밋 대부분에 코딩 에이전트가 함께 이름을 올리고 있다. 결정적인 껍데기를 비결정적인 지능이 쓰고 있는 셈이다. 억지력이 없는 내부자를 통제 장치만으로 묶어야 한다는 부담도 그대로 남는다. 그래도 방향은 바뀌지 않는다. 가장 믿을 만한 시스템은 가장 믿는 모델 위에 서지 않고, 그 모델을 가장 덜 믿어도 되는 구조 위에 선다.


