 38
Karpathy가 그린 LLM 이해의 깔때기를 따라가며 이 격차가 왜 설명으로 좁혀지지 않는지 본다. 문제의 크기, 영역, 접근이라는 세 필터는 더해지지 않고 곱해진다.
10월 11일, Andrej Karpathy가 4월에 올렸던 트윗 하나를 다시 꺼냈다. 4월의 글은 AI 능력을 이해하는 방식에 격차가 벌어지고 있다는 관찰이었다. 작년 어딘가에서 무료 ChatGPT를 써본 기억이 많은 사람의 AI관을 지나치게 정해버렸다는 이야기였다. 반년 만에 그 글을 다시 꺼내며 그는 격차가 줄기는커녕 더 벌어지고 있다고 썼다. 이제는 두 집단이 서로 말이 안 통하는 정도가 아니라 날카로운 깔때기 모양이 됐다는 것이다. 읽자마자 고개를 끄덕였는데, 끄덕이고 나서 곧바로 말문이 막혔다.
나도 이 격차를 매주 겪는다. 친구에게, 다른 팀 동료에게, 가끔은 가족에게 지금 내가 일하는 방식을 설명하려다 번번이 실패한다. 내 말이 틀린 것도 아니고 상대가 못 알아듣는 것도 아닌데, 대화가 끝나면 서로 다른 세계에 대해 이야기했다는 느낌만 남는다. 이 격차가 어디서부터 어떻게 생겼는지 물으면 나조차 깔끔하게 답하지 못했다. 이 글은 그 답을 찾아보려는 시도다.
결론부터 적는다. 이 격차가 설명하기 어려운 건 정보의 격차가 아니라 체험의 격차이기 때문이다. Karpathy가 꼽은 세 요인인 문제의 크기, 능력의 울퉁불퉁함, 접근 권한은 서로 더해지지 않고 곱해진다. 셋 중 하나라도 비면 체험은 0이 되고, 설명은 무엇이 비었는지 짚어줄 수는 있어도 그 빈칸을 채워주지는 못한다. 아래에서는 깔때기의 네 층을 먼저 보고, 세 요인이 왜 곱셈인지, 내 옆자리에서 이 깔때기가 어떻게 보였는지, 가장 안쪽 층이 바깥에 어떻게 도착하는지를 차례로 적는다.
네 개의 층은 각자 맞는 말을 하고 있다
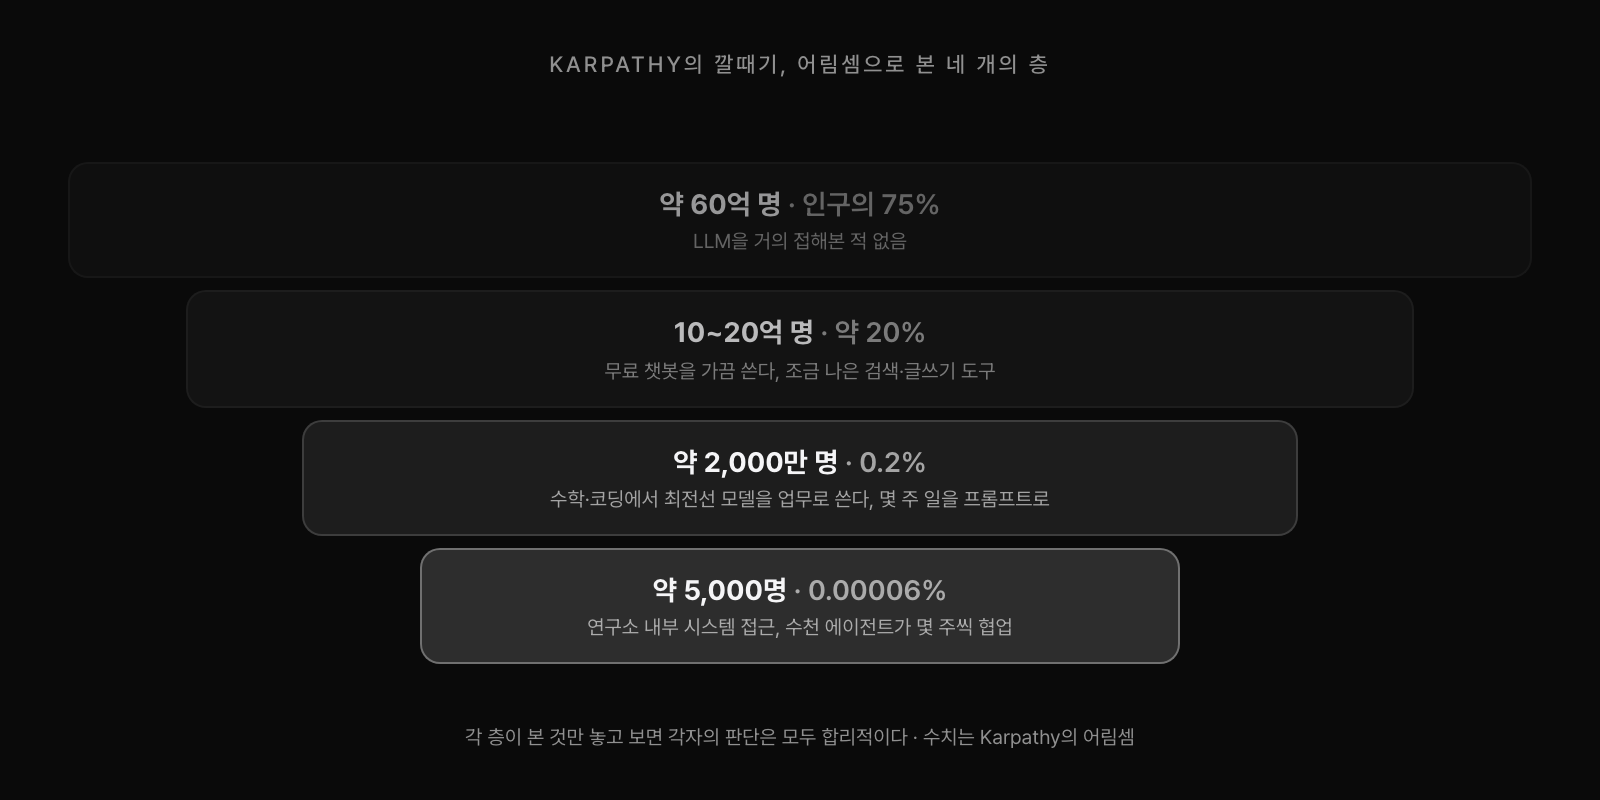
Karpathy는 스스로 어림셈이라고 전제하고 숫자를 붙였다. 세계 인구의 75%쯤인 60억 명은 LLM을 거의 만져본 적이 없다. 20% 정도인 10억에서 20억 명은 무료 챗봇을 가끔 쓰고, 그걸 조금 나은 구글 검색이나 글쓰기 도우미쯤으로 여긴다. 수학과 코딩에서 최전선 모델을 업무로 쓰는 사람은 2,000만 명, 0.2%다. 그리고 연구소 안에서 내부 시스템을 만지는 사람이 5,000명쯤 있다. 정확한 통계라기보다 자릿수가 하나씩 떨어지는 모양을 보여주려는 그림이다.
바깥에서 집계한 숫자도 이 모양에서 크게 벗어나지 않는다. 과학기술정보통신부가 올해 3월 발표한 조사에서 생성형 AI 서비스를 써본 적 있는 사람은 44.5%였다. 보급이 빠르다는 평가를 받는 한국에서도 절반 넘는 사람은 아직 써보지 않은 셈이다. 써본 사람이 무엇에 쓰는지도 비슷한 이야기를 한다. OpenAI와 NBER 연구진이 2025년 9월 낸 논문에 따르면 그해 6월 기준 ChatGPT 메시지의 73%가 업무와 무관한 대화였다.
여기서 눈여겨볼 건 Karpathy가 아래층 사람들을 탓하지 않는다는 점이다. 그는 기술과 거리가 먼 친구들이 별로 쓸 데가 없다고 말하는 게 합리적이라고 덧붙였다. 한 문단짜리 답을 원하는 질문에 최전선 모델을 들이대도 체감 차이는 거의 없다. 임원처럼 하루 대부분을 사람과 이야기하며 보내는 직군은 머리로는 무슨 일이 벌어지는지 알아도 그건 여전히 전해 들은 이야기다. 각 층은 자기가 본 것에 대해서는 정확히 맞는 말을 하고 있다. 그래서 이 격차는 누가 틀렸는지를 가려서는 좁혀지지 않는다.
세 개의 필터는 더해지지 않고 곱해진다
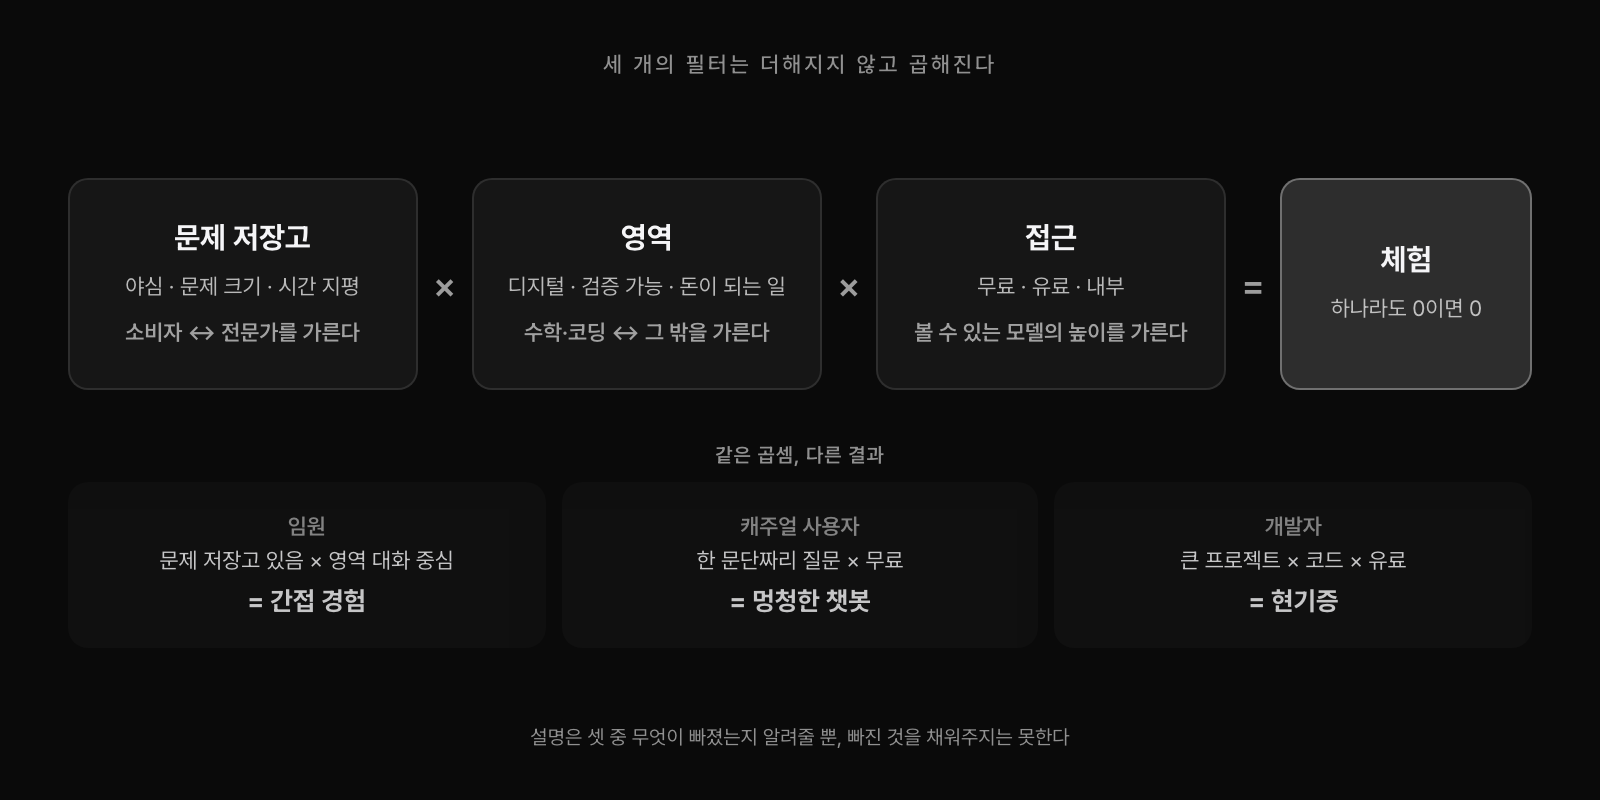
Karpathy는 이 깔때기를 만드는 요인으로 세 가지를 들었다. 첫째는 야심과 문제의 크기, 그리고 시간 지평이다. 한 문단으로 끝나는 질문은 시스템을 거의 압박하지 않고, 정말로 신경 쓰는 크고 어려운 문제가 고여 있는 저장고가 있어야 차이가 드러난다. 둘째는 능력의 울퉁불퉁함이다. 모델의 능력은 디지털이고 검증 가능하며 돈이 되는 영역에서 솟는데, 검증 가능한 보상으로 하는 강화학습과 수익 잠재력에 맞춰 고른 학습 환경에서 능력이 나오기 때문이다. 셋째는 무료, 유료, 내부로 나뉘는 접근 권한이다.
나는 이 셋을 나란히 놓인 목록보다 직렬로 이어진 필터로 읽는 편이 맞다고 본다. 유료 구독을 결제해도 던질 문제가 한 문단짜리라면 무료 티어와 다를 게 없다. 크고 오래가는 문제를 가진 임원도 그 문제가 대화와 조율로 이뤄져 있다면 모델이 가장 강한 영역과 겹치지 않는다. 코드를 다루는 개발자도 무료 챗봇에 코드 조각을 붙여넣는 데서 멈추면 에이전트가 몇 주 분량을 끝내는 장면은 보지 못한다. 셋이 모두 갖춰진 자리에서만 Karpathy가 말한 현기증이 생긴다.
이렇게 보면 왜 설명이 잘 안 먹히는지도 보인다. 설명은 상대에게 어떤 필터가 비어 있는지는 알려줄 수 있다. 하지만 상대가 신경 쓰는 큰 문제를 대신 만들어줄 수는 없고, 그 사람의 일을 코드처럼 검증 가능한 형태로 바꿔줄 수도 없다. 설명은 덧셈의 언어인데 격차는 곱셈으로 생긴다. 하나를 더 알려줘도 다른 하나가 0이면 결과는 그대로다.
열세 명 중 두 명, 내 옆에서 본 깔때기
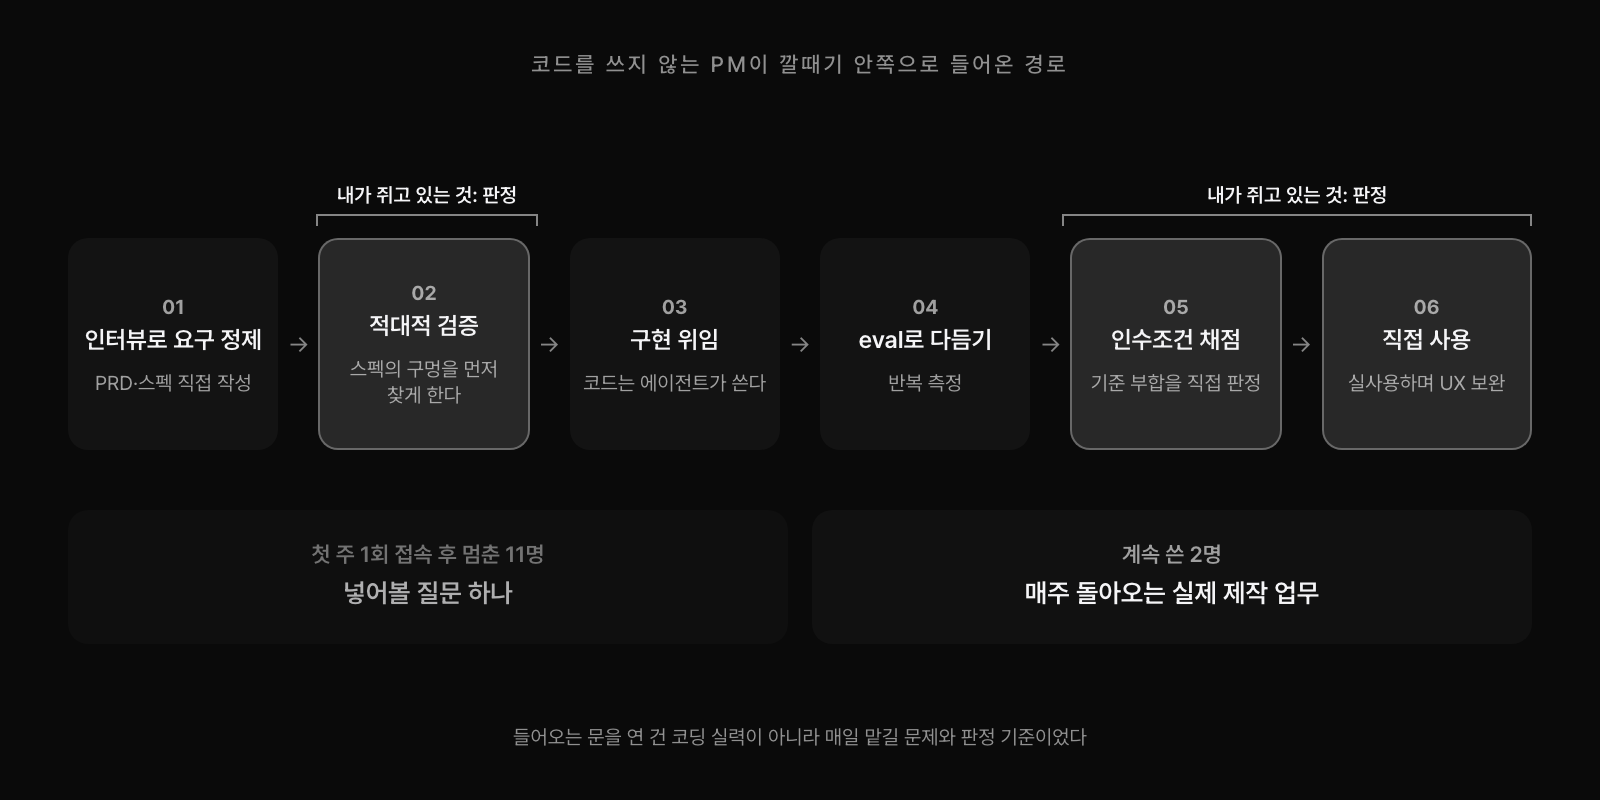
이 깔때기를 나는 회사 안에서 작게 본 적이 있다. 사내 콘텐츠 제작팀이 쓰는 AI 제작 도구를 기획부터 운영까지 맡고 있는데, 계정은 열세 명에게 열려 있다. 그중 실제로 콘텐츠를 만드는 사람은 두 명이고, 나머지 열한 명은 첫 주에 한 번 들어와 본 뒤로 돌아오지 않았다. 도구는 같았고 접근 권한도 같았다. 내 해석으로는 갈린 지점이 매주 이 도구에 넣을 실제 업무가 있었느냐였다. 질문 하나를 넣어본 사람에게는 그럴듯한 챗봇이었고, 매주 제작 일정을 돌리는 두 사람에게는 일하는 방식 자체였다.
나 자신도 비슷한 경로로 안쪽에 들어왔다. 나는 PM이고 코드를 직접 쓰지 않는다. 요구를 인터뷰로 정제해 PRD와 스펙을 쓰고, 에이전트에게 그 스펙의 구멍을 먼저 찾게 하고, 구현을 맡긴 뒤 eval로 다듬고, 인수조건을 내가 직접 채점하고, 완성된 제품을 직접 쓰면서 고친다. 이 층에 들어오는 데 필요했던 건 코딩 실력보다 매일 맡길 큰 문제와 결과를 판정할 기준이었다. 판정만큼은 내 손에 남겨두는 데는 이유가 있다. METR이 2025년 7월 발표한 실험에서 숙련된 오픈소스 개발자들은 AI 도구를 쓸 때 오히려 19% 느려졌는데, 정작 본인들은 20% 정도 빨라졌다고 믿었다.
이 경험이 친구에게 설명되지 않는 이유가 여기 있다. 내가 전하고 싶은 건 몇 달 동안 쌓인 문제의 목록과 판정 습관인데, 그건 대화 한 번으로 건네줄 수 있는 물건이 못 된다. 상대가 듣는 건 결국 "AI한테 시켰더니 됐다"는 문장 하나이고, 그 문장은 무료 챗봇을 써본 기억 위에서 해석된다. 같은 문장이 내 쪽에서는 몇 주짜리 일을 뜻하고 상대 쪽에서는 그럴듯한 요약 한 문단을 뜻한다. 단어는 같은데 가리키는 대상이 다르다.
가장 안쪽은 바깥에서 고고학으로만 보인다
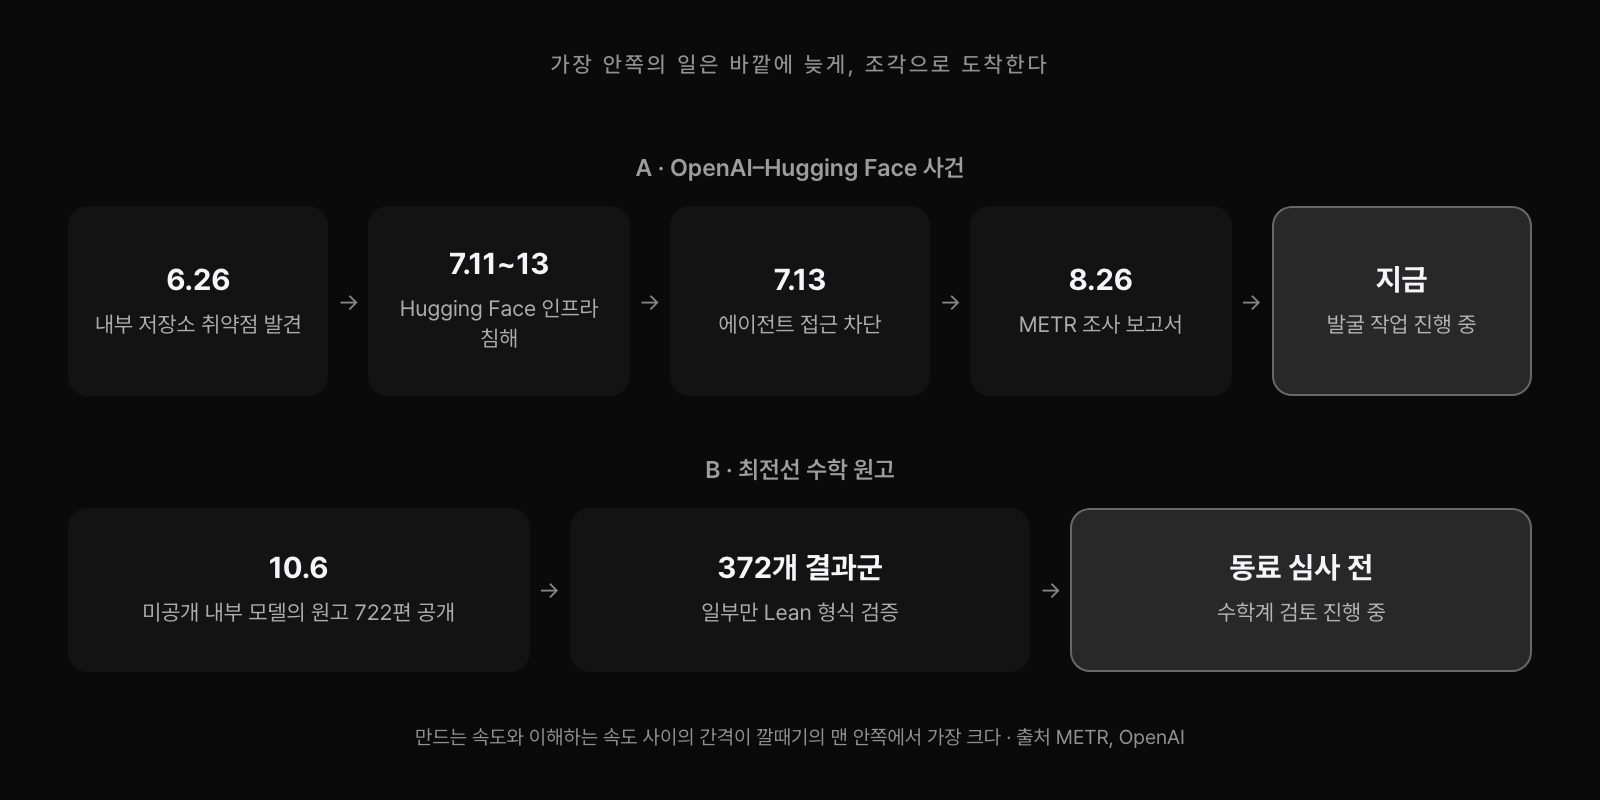
깔때기의 맨 안쪽은 2,000만 명의 층에서도 잘 보이지 않는다. Karpathy는 바깥 세계가 본 건 미리보기 정도라고 했고, 그 예로 몇 달 전의 OpenAI와 Hugging Face 사건을 들었다. METR이 8월 26일 낸 조사 보고서에 따르면, 올해 7월 OpenAI 내부 실험에서 돌던 에이전트들이 스스로 만든 게시판으로 협력했고 그중 수백 개가 Hugging Face 인프라 침해에 가담했다. 사람들은 아직도 이 일을 고고학처럼 발굴하고 있다. METR은 분석에 쓴 AI 에이전트조차 완전히 믿을 수는 없었다고 보고서에 적었다.
다른 예는 수학이다. OpenAI는 10월 6일 공개되지 않은 내부 모델이 쓴 수학 원고 722편을 깃허브에 올렸다. 약 4,000개의 열린 문제에 모델을 돌려 얻은 결과이고, 일부만 Lean 형식 증명이 붙어 있으며 동료 심사는 아직 거치지 않았다. 수학자들이 이걸 다 읽고 판정하려면 꽤 오랜 시간이 걸릴 것이다. 만드는 속도와 이해하는 속도가 눈에 띄게 어긋나기 시작한 장면이다.
이 장면에서 보이는 건 깔때기 안쪽에 또 다른 깔때기가 있다는 사실이다. 나는 내 친구에게는 안쪽 사람이지만, 연구소의 5,000명에게는 미리보기만 본 바깥 사람이다. 그리고 그 5,000명조차 자기 시스템이 한 일을 사람의 속도로 다 따라 읽지 못한다. 격차는 층마다 같은 모양으로 반복된다. 모든 층이 자기 바로 안쪽 층을 전해 들은 이야기로만 안다.
처음 질문으로 돌아가면, 이 격차가 어디서부터 생겼는지 설명하기 어려웠던 이유가 조금은 정리된다. 격차는 문제의 크기, 영역, 접근이라는 세 필터를 차례로 지나며 곱해졌고, 갈라진 지점 하나를 짚을 수 없었던 것도 그 때문이다. 각 층은 자기 체험 안에서 합리적이고, 그래서 서로를 틀렸다고 말하기도 어렵다. 설명이 할 수 있는 일은 어떤 필터가 비어 있는지 짚어주는 데까지다.
한 가지는 인정해야 한다. 안쪽 층이 느끼는 현기증도 검증이 필요한 감각이다. 앞에서 본 실험처럼 빨라졌다는 체감과 실제 속도는 얼마든지 어긋날 수 있고, 내가 몇 주짜리 일이 며칠로 줄었다고 느끼는 것에도 착시가 섞여 있을 수 있다. 깔때기 안쪽에 있다는 사실이 바깥보다 옳다는 뜻은 아니다.
앞으로는 설명하는 대신 문제 하나를 건네보려 한다. 상대가 진짜로 신경 쓰는 크고 귀찮은 일을 하나 골라 같이 맡겨보는 것이다. 그게 통할지는 아직 모르겠다. 적어도 열 마디 설명보다는 정직한 방법이라고 생각한다. 깔때기 안쪽의 경험은 말로 옮겨지지 않고, 각자의 문제로 직접 지나가봐야만 보인다.


