30
Claude Code 지시 파일에서 비용을 만드는 건 에이전트가 적힌 지시를 성실하게 따른다는 사실입니다. 2026년 ETH Zurich 연구에서 지시 파일은 작업 성공률을 거의 올리지 못하고 비용을 20% 넘게 올렸는데, 연구진은 그 원인을 에이전트가 지시를 따르느라 탐색과 테스트를 늘린 탓으로 봤습니다. LeanX가 2026년 11월 6일 자기 Claude Code 지시 파일 1,000줄(자동으로 읽히는 667줄과 읽으라고 적어 둔 333줄)을 열어 보니 낡은 모델 이름, 없는 도구 이름, 서로 부딪히는 규칙이 섞여 있었습니다. 그래서 LeanX는 줄마다 두 가지만 묻습니다. 모든 작업에 필요한가, 기계가 잡을 수 있는가.
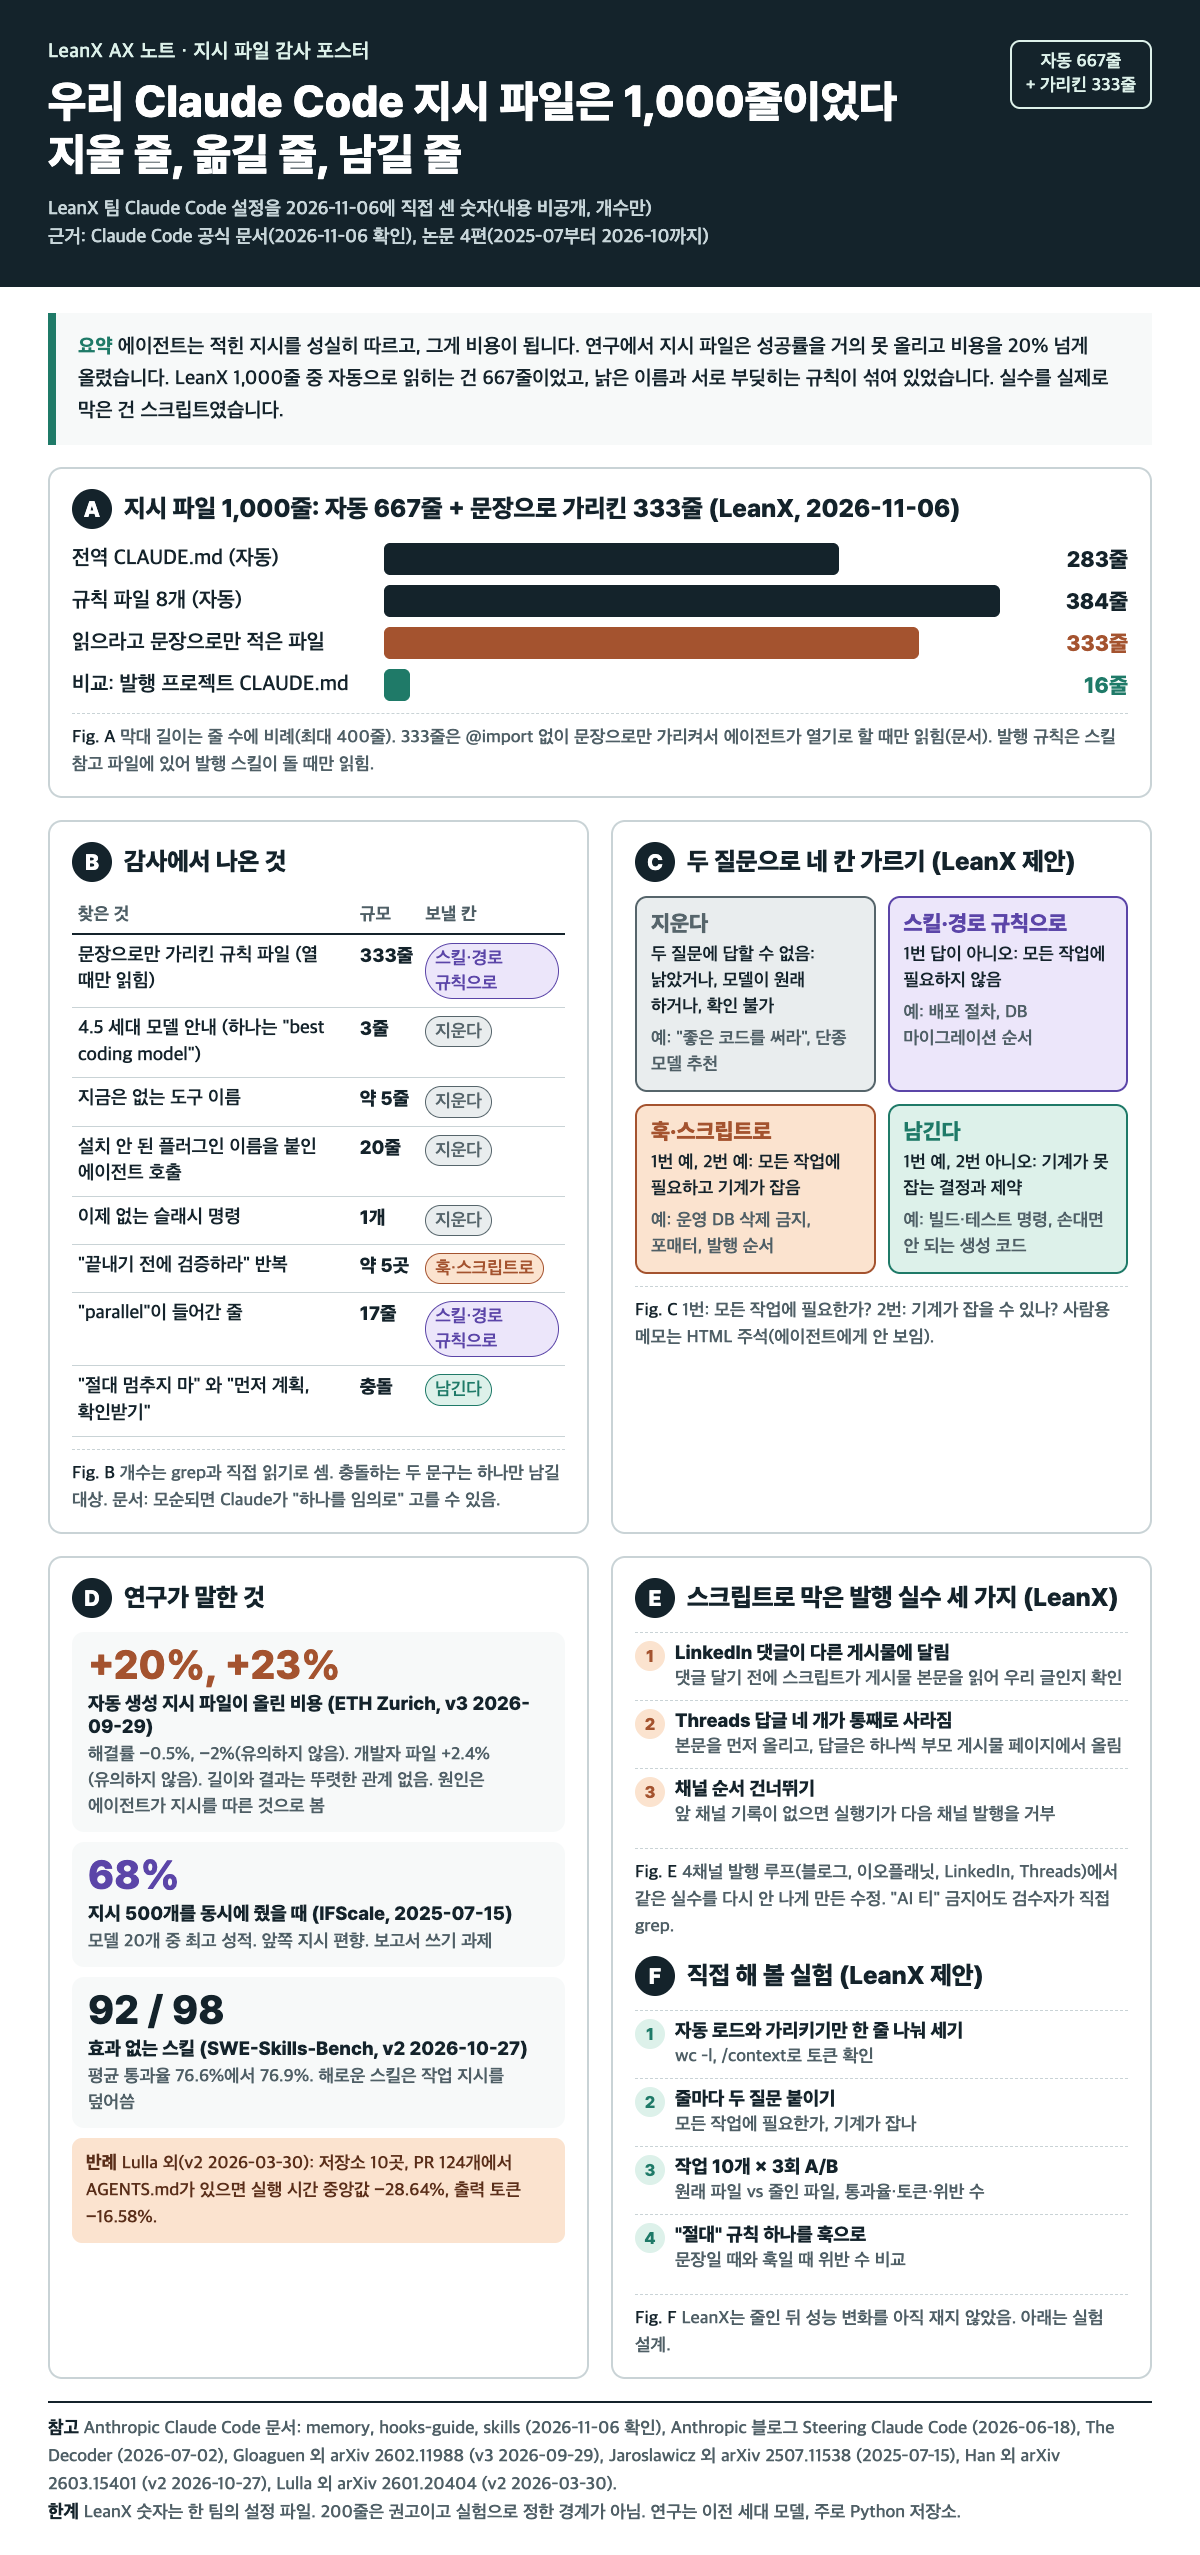
그림 1. LeanX가 자기 Claude Code 지시 파일을 감사한 결과와 근거 연구를 한 장에 모은 포스터. 숫자와 출처는 본문에 다시 적었습니다.
솔직히 고백부터 하겠습니다. 에이전트가 실수를 하면 저희는 지시 파일에 한 줄을 보탰습니다. "다음부턴 이렇게 해." 한 줄은 늘 합리적이었고, 몇 달 뒤 세어 보니 1,000줄이었습니다. 이 글은 그 1,000줄을 열어 본 기록이고, 다른 팀이 자기 파일에 그대로 써 볼 수 있는 분류 기준을 LeanX 제안으로 붙였습니다.
지시 파일 1,000줄은 실제로 얼마나 읽히고 있었나요?
자동으로 읽히는 건 667줄이었습니다. 나머지 333줄은 "이 파일을 읽어라"라는 문장으로만 가리켜 둔 파일이라, 에이전트가 열기로 할 때만 읽힙니다. 세어 보기 전까지 저희는 1,000줄이 매번 다 읽힌다고 생각했습니다.
2026년 11월 6일 LeanX 팀 Claude Code 설정의 줄 수를 셌습니다.
· 전역 CLAUDE.md: 283줄 (매 세션 자동으로 읽힘)
· 개인 규칙 폴더의 규칙 파일 8개: 합쳐서 384줄 (paths가 없어서 매 세션 자동으로 읽힘)
· 전역 CLAUDE.md가 문장으로 "늘 읽으라"고 가리키는 규칙 파일 하나: 333줄 (@import가 아니어서 자동으로는 안 읽힘)
Claude Code 메모리 문서(2026-11-06 확인)는 AGENTS.md를 예로 들어 이렇게 설명합니다. CLAUDE.md가 말로 AGENTS.md를 읽으라고 하면 "Claude sees AGENTS.md only if it decides to open the file", 즉 Claude가 그 파일을 열기로 정할 때만 보입니다. 같은 원리라면 저희 333줄도 에이전트가 그날 열어 보기로 해야 적용됩니다(LeanX 해석). 꼭 지켜야 할 규칙을 거기 둔 거라면, 지켜질지는 운에 맡긴 셈입니다. 반드시 읽혀야 하면 @import로, 일부 작업용이면 스킬로 옮겨야 합니다.
비교하면 이 블로그 글을 쓰고 4개 채널에 발행하는 프로젝트의 CLAUDE.md는 16줄입니다. 어떤 요청이 오면 어떤 스킬과 실행기를 쓰라는 안내와 변경 이력이 전부입니다. 길고 자세한 발행 규칙은 스킬의 참고 파일에 들어 있어서, 발행 스킬이 돌 때만 읽힙니다.
1,000줄을 한 줄씩 보니 이런 것들이 더 나왔습니다. 파일 내용은 공개하지 않고, 종류와 개수만 적습니다.
[찾은 것] 문장으로만 가리킨 규칙 파일
[규모] 333줄 / [왜 문제인가] 에이전트가 열기로 할 때만 적용됨
[찾은 것] 4.5 세대 모델을 이름으로 안내하는 줄 (그중 하나는 "best coding model")
[규모] 3줄 / [왜 문제인가] 모델 선택을 낡은 기준으로 하게 만듦
[찾은 것] 지금 Claude Code에 없는 도구 이름
[규모] 약 5줄 / [왜 문제인가] 없는 도구를 찾느라 헤매거나 지시를 무시함
[찾은 것] 설치돼 있지 않은 플러그인 이름을 붙인 에이전트 호출
[규모] 20줄 / [왜 문제인가] 같은 에이전트가 다른 이름으로 로컬에 있는데 틀린 이름으로 부르라고 지시
[찾은 것] 이제 없는 슬래시 명령
[규모] 1개 / [왜 문제인가] 존재하지 않는 기능 안내
[찾은 것] "끝내기 전에 검증하라"는 같은 말
[규모] 약 5곳 / [왜 문제인가] 같은 지시를 여러 번 읽힘
[찾은 것] "parallel(병렬)"이 들어간 줄
[규모] 17줄 / [왜 문제인가] 작은 작업에도 병렬 실행을 밀어붙이는 압력
[찾은 것] "절대 멈추지 마라" 같은 상시 모드 문구와 "먼저 계획하고 확인받아라" 문구
[규모] 서로 충돌 / [왜 문제인가] 둘 중 하나를 임의로 고를 수 있음
마지막 줄이 제일 아팠습니다. Anthropic 문서는 두 지시가 모순되면 Claude가 "하나를 임의로 고를 수 있다"고 적고 있습니다. 저희 파일은 한쪽에서 끝까지 멈추지 말라고 하고, 다른 쪽에서 사소하지 않은 일은 계획부터 세우고 확인받으라고 했습니다. 에이전트가 어느 날은 묻고 어느 날은 밀어붙였다면, 모델 탓만은 아니었던 겁니다.
모두 한때는 맞는 줄이었습니다. 모델이 바뀌고, 도구 이름이 바뀌고, 플러그인을 지우고 에이전트를 직접 깔았는데 지시 파일만 그대로였습니다. 코드라면 이런 이름 불일치는 실행하자마자 에러가 났겠지만, 지시 파일은 에러를 내지 않습니다.
에이전트는 왜 지시를 따를수록 비싸지나요?
에이전트가 말을 안 들어서 생기는 일이 아닙니다. 너무 잘 들어서 생깁니다. 적힌 지시를 지키느라 탐색하고, 테스트를 더 돌리고, 더 오래 생각합니다. 그 일이 지금 하는 작업에 필요 없으면 비용만 남습니다. LeanX는 이게 지시 파일 문제의 대부분이라고 봅니다.
이걸 숫자로 보여 준 연구가 ETH Zurich의 Gloaguen 등이 쓴 Evaluating AGENTS.md(arXiv 2602.11988, 첫 판 2026-02-12, 현재 v3 2026-09-29)입니다. Claude Code(Sonnet 4.5), Codex(GPT-5.2, GPT-5.1 mini), Qwen Code로 SWE-bench Lite와 연구진이 만든 CTXbench 문제를 풀게 했습니다.
· 에이전트가 자동으로 만든 지시 파일은 해결률을 SWE-bench Lite에서 0.5%, CTXbench에서 2% 낮췄습니다. 통계적으로 의미 있는 차이는 아니었습니다(p값 87%, 37%). 반면 비용은 평균 20%와 23% 올랐습니다.
· 개발자가 직접 쓴 지시 파일은 평균 2.4% 올렸지만 역시 유의하지 않았고(p=21%), 네 에이전트 중 Claude Code에서는 오르지 않았습니다. 그래도 자동 생성 파일보다는 확실히 나았습니다(p=3.8%).
· 연구진은 에이전트가 지시 파일의 지시를 잘 따랐다고 확인했고, 비용이 늘어난 이유를 "에이전트가 지시를 따르는 경향"으로 설명했습니다. 파일 길이와 결과 사이에는 뚜렷한 관계가 없었습니다. 몇 줄이냐보다 그 줄이 무슨 일을 시키느냐가 비용을 정한다는 얘기입니다.
연구진의 권고는 구체적입니다. 자동 생성한 지시 파일은 당분간 빼고, 사람이 쓰는 파일에는 README에 없는 것, 예를 들어 그 팀만의 규칙이나 비기능 요구사항만 넣으라는 겁니다.
지시가 쌓이면 다 지키기도 어려워집니다. IFScale 연구(Jaroslawicz 등, 2025-07-15)는 보고서에 넣어야 할 키워드 지시를 500개까지 늘리며 모델 20개를 시험했는데, 가장 잘한 모델도 500개에서 68%만 지켰고 앞쪽에 적힌 지시를 더 잘 지키는 경향을 보였습니다. 과제가 보고서 쓰기라는 점은 감안해야 합니다.
스킬도 마찬가지입니다. SWE-Skills-Bench(Han 등, v2 2026-10-27)는 공개 스킬 98개를 시험했고 92개가 통계적으로 의미 있는 효과가 없었습니다. 평균 통과율은 76.6%에서 76.9%로 거의 그대로였습니다. 해로운 스킬은 에이전트가 스킬에 든 템플릿을 충실히 따르다 작업에 적힌 지시를 덮어쓰게 만들었습니다(최대 −17.0점). 도움이 된 소수는 에이전트가 원래 빼먹던 절차를 채워 줬습니다(최대 +17.7점). 여기서도 성실함이 양쪽으로 작동했습니다.
반대 방향 결과도 있습니다. Lulla 등의 연구(arXiv 2601.20404, v2 2026-03-30)는 저장소 10곳, PR 124개에서 AGENTS.md가 있을 때 실행 시간 중앙값이 28.64%, 출력 토큰이 16.58% 줄었고 완료 정도는 비슷했다고 봤습니다. 작업에 맞는 지시는 헤매는 시간을 줄여 준다는 얘기이고, LeanX의 해석과도 맞습니다.
[연구 (날짜)] Gloaguen 등, ETH Zurich (v3 2026-09-29)
[무엇을 쟀나] 지시 파일 유무에 따른 해결률과 비용 / [결과] 자동 생성 파일: 해결률 −0.5%, −2%(유의하지 않음), 비용 +20%, +23%. 개발자 파일: +2.4%(유의하지 않음). 길이와는 뚜렷한 관계 없음 / [조심할 점] Python 저장소, Sonnet 4.5 등 이전 세대 모델
[연구 (날짜)] IFScale (2025-07-15)
[무엇을 쟀나] 동시에 준 지시 개수와 준수율 / [결과] 지시 500개에서 최고 모델도 68%, 앞쪽 지시 편향 / [조심할 점] 키워드 넣기 과제, 보고서 쓰기
[연구 (날짜)] SWE-Skills-Bench (v2 2026-10-27)
[무엇을 쟀나] 스킬 98개의 효과 / [결과] 92개 효과 없음, 통과율 76.6%에서 76.9% / [조심할 점] 스킬마다 요구사항 10개씩
[연구 (날짜)] Lulla 등 (v2 2026-03-30)
[무엇을 쟀나] AGENTS.md 유무에 따른 시간과 토큰 / [결과] 실행 시간 중앙값 −28.64%, 출력 토큰 −16.58% / [조심할 점] 저장소 10곳, PR 124개로 작음
LeanX는 줄마다 무엇을 묻나요?
두 가지입니다. 첫째, 이 줄은 모든 작업에 필요한가. 둘째, 이 줄이 지키라는 걸 기계가 잡을 수 있는가. 두 질문에 답하면 줄이 갈 곳이 정해집니다. 아래는 LeanX가 자기 파일을 보며 만든 제안입니다.
1. 모든 작업에 필요한가? 아니라면 그 줄은 매 세션 읽힐 이유가 없습니다. 일부 작업용 절차는 스킬로, 일부 폴더용 규칙은 paths가 붙은 규칙 파일로 보냅니다. 에이전트는 읽은 지시를 성실히 따르니, 필요 없는 작업에서까지 따르게 두면 그만큼 비용입니다.
2. 기계가 잡을 수 있는가? 모든 작업에 필요하고 기계가 판정할 수 있다면 훅, 린터, CI, 실행기 검사로 보냅니다. 판정할 수 없는 결정과 제약만 CLAUDE.md에 남깁니다.
두 질문에 답할 수조차 없는 줄은 지웁니다. 모델이 원래 하는 일("좋은 코드를 써라"), 이제 없는 이름, 맞는지 확인할 방법이 없는 말이 여기 들어갑니다.
[칸] 지운다
[두 질문의 답] 답할 수 없음: 낡았거나, 모델이 원래 하거나, 확인할 방법이 없음 / [예시] "좋은 코드를 써라", 단종된 모델 추천, 없는 도구 이름 / [보낼 곳] 삭제. 사람에게 남길 설명은 HTML 주석
[칸] 스킬·경로 규칙으로 옮긴다
[두 질문의 답] 모든 작업에 필요하지 않음 / [예시] 배포 절차, DB 마이그레이션 순서, 프런트엔드 스타일 / [보낼 곳] 스킬(호출될 때 본문 로드) 또는 paths가 붙은 규칙
[칸] 훅·스크립트로 옮긴다
[두 질문의 답] 모든 작업에 필요하고, 기계가 잡을 수 있음 / [예시] 운영 DB 삭제 금지, 포매터, 타입 검사, 발행 순서 / [보낼 곳] PreToolUse 훅, 린터, CI, 실행기 검사
[칸] 남긴다
[두 질문의 답] 모든 작업에 필요하지만, 기계가 잡을 수 없음 / [예시] 빌드·테스트 명령, 손대면 안 되는 생성 코드 폴더, 팀이 정한 예외 / [보낼 곳] CLAUDE.md
저희 감사 결과에 두 질문을 대 보면 손볼 계획은 이렇습니다. 아직 고치기 전이고, 하나씩 옮겨 볼 생각입니다. 낡은 모델 안내, 없는 도구와 플러그인 이름, 없는 명령은 지울 겁니다. 병렬 실행 지침은 오케스트레이션이 필요한 작업에서만 쓰는 스킬로 옮기려고 합니다. 다섯 군데 적힌 "끝내기 전에 검증하라"는 실행기의 완료 검사로 옮길 후보입니다. 충돌하는 두 모드 문구는 하나만 남길 계획이고, 문장으로 가리키던 333줄은 꼭 필요한 몇 줄만 골라 CLAUDE.md로 올리고 나머지는 스킬 참고 파일로 보낼 생각입니다.
Anthropic 문서는 이 분류에 어떤 장치를 주나요?
네 칸마다 쓸 장치가 Claude Code에 이미 있습니다. 공식 문서 기준으로 하나씩 짚으면 이렇습니다.
· CLAUDE.md 크기: 메모리 문서는 "target under 200 lines per CLAUDE.md file. Longer files consume more context and reduce adherence"라고 적었습니다. 2026년 6월 18일 Anthropic 블로그 글도 200줄 아래, 담당자 지정, 코드처럼 리뷰하기를 권했습니다. 200이라는 숫자 뒤에 실험이 붙어 있지는 않으니 경험에서 나온 권고로 읽으면 됩니다.
· @import로 가져온 파일은 원래 파일과 함께 로드되므로 컨텍스트 비용은 그대로입니다. 보기 좋게 나눌 뿐입니다.
· 규칙 파일 가운데 paths가 없는 것은 시작할 때 전부 로드되고, 홈 폴더의 개인 규칙은 모든 프로젝트에 적용됩니다. paths를 붙이면 그 파일을 만질 때만 읽힙니다.
· 스킬: 스킬 문서에 따르면 설명만 늘 컨텍스트에 있고 본문은 호출될 때 로드됩니다. 한 번 호출된 스킬은 그 뒤로도 남으니 비용이 사라지진 않습니다.
· 훅: 훅 문서는 훅을 "LLM이 실행하기로 고르는 데 기대지 않고 특정 동작이 항상 일어나게 하는 결정적 제어"라고 설명하고, 종료 코드 2로 동작을 막을 수 있다고 적었습니다. 메모리 문서도 CLAUDE.md는 강제 설정이 아닌 컨텍스트이니 반드시 막을 동작은 PreToolUse 훅을 쓰라고 합니다.
· 블록 단위 HTML 주석(<!-- 메모 -->)은 컨텍스트에 넣기 전에 지워집니다. 남긴 줄에 붙일 이유와 날짜는 여기 두면 공짜입니다.
· /doctor prompt-audit: v2.1.283 이상에서 예전 모델용 지시, 없는 파일이나 명령을 가리키는 줄, 서로 모순되는 파일을 찾아 수정안을 보고합니다. 저희가 손으로 찾은 것과 종류가 거의 겹칩니다.
Anthropic 스스로도 줄이는 쪽으로 갔습니다. The Decoder는 2026년 7월 2일 보도에서 Anthropic 엔지니어 Thariq Shihipar가 Claude Code 시스템 프롬프트를 80% 줄였다고 공개적으로 말했다고 전했습니다. 그의 표현은 "이번 세대 모델은 더 작은 시스템 프롬프트를 원한다"였습니다. Anthropic이 따로 글로 낸 발표는 찾지 못했고, 줄이기 전후의 토큰 수는 보도마다 달라서 옮기지 않습니다.
문장보다 스크립트가 실수를 막은 사례가 있나요?
있습니다. LeanX가 블로그, 이오플래닛, LinkedIn, Threads 4개 채널에 글을 내보내는 발행 루프에서, 같은 실수가 다시 안 나게 만든 건 매번 코드였습니다. 두 번째 질문("기계가 잡을 수 있나?")에 그렇다고 답한 줄들입니다.
1. LinkedIn 댓글이 엉뚱한 게시물에 달렸습니다. 블로그 링크를 단 첫 댓글이 다른 게시물에 붙은 일이 있었고, 바로 지웠습니다. 고친 방법은 스크립트 검사였습니다. 댓글을 달기 전에 스크립트가 열린 게시물의 본문을 읽어 우리가 올린 글이 맞는지 확인합니다.
2. Threads 답글 네 개가 통째로 사라졌습니다. 작성 창에서 본문과 답글을 한 번에 이어 붙였더니 본문만 올라갔습니다. 지금은 스크립트가 본문을 먼저 올리고, 답글은 하나씩 부모 게시물 페이지에서 올립니다.
3. 채널 순서를 건너뛸 수 없게 했습니다. 실행기는 앞 채널의 발행 기록이 남기 전에는 다음 채널 발행을 거부합니다. 블로그가 확인되기 전에 소셜 글이 나가는 일은 문장으로 부탁하지 않습니다.
"AI 티 나는 표현"도 마찬가지입니다. 금지어 목록이 문서에 있긴 하지만, 실제로 걸러 내는 건 검수 단계에서 그 목록을 직접 grep하는 독립 검수자입니다. 이 글도 그 검사를 통과해야 나갑니다.
문장으로 적은 규칙은 에이전트가 기억하고 골라서 따라야 합니다. 스크립트로 적은 규칙은 고를 여지가 없습니다.
우리 팀에서 반나절 실험은 어떻게 하나요?
LeanX는 아직 줄인 뒤 성능이 좋아졌는지 재 보지 않았습니다. 그래서 아래는 실험 설계입니다. 반나절이면 해 볼 수 있습니다.
1. 자동으로 읽히는 줄과 가리키기만 한 줄을 나눠 셉니다. 전역 CLAUDE.md, 프로젝트 CLAUDE.md, paths 없는 규칙 파일, @import된 파일은 자동입니다. 문장으로 "읽어라"라고만 적은 파일은 따로 셉니다. Claude Code의 /context로 실제 토큰도 봅니다.
2. 줄마다 두 질문을 붙입니다. 모든 작업에 필요한가, 기계가 잡을 수 있는가. 답에 따라 네 칸 중 하나로 보냅니다. /doctor prompt-audit(v2.1.283 이상)의 보고서를 같이 놓고 보면 놓친 낡은 줄을 찾기 쉽습니다.
3. 작은 A/B를 돌립니다. 팀이 자주 하는 작업 10개를 고정하고, 원래 파일과 줄인 파일로 각각 3번씩 돌립니다. 테스트 통과율, 토큰, 턴 수, 꼭 지켜야 할 규칙을 어긴 횟수를 적습니다. 여유가 있으면 줄인 파일과 길이는 같지만 상관없는 글을 채운 파일도 하나 넣으면, 길이 효과와 내용 효과를 나눠 볼 수 있습니다.
4. "절대" 규칙 하나를 훅으로 옮깁니다. 문장으로 뒀을 때 어긴 횟수와 훅으로 막았을 때를 비교합니다.
한계
LeanX 감사 숫자는 우리 팀 한 곳의 설정 파일을 2026년 11월 6일에 센 것이고, 줄인 뒤 성능 변화는 재지 않았습니다. 333줄이 실제로 몇 세션에서 열렸는지는 세지 않았습니다. 200줄은 Anthropic의 권고이고 실험으로 정해진 경계가 아닙니다. 연구들은 이전 세대 모델(Sonnet 4.5, GPT-5.2 등)과 주로 Python 저장소, 또는 보고서 쓰기 과제로 실험했습니다. 시스템 프롬프트 80% 축소는 Anthropic 엔지니어의 공개 발언을 전한 보도로만 확인했습니다. Claude Code의 명령과 로딩 규칙은 버전마다 바뀌니 자기 버전의 문서를 다시 확인하세요.
지시 파일 감사는 줄을 세는 데서 시작해 훅 하나를 붙이는 데서 끝납니다.
LeanX는 AX 컨설팅과 AI 자동화 구축을 하는 팀입니다. 우리 팀 에이전트 설정에서 지울 줄, 스킬로 옮길 줄, 스크립트로 막을 규칙을 회사 상황에 맞춰 같이 골라 볼 수 있어요. 어디부터 볼지 모르겠다면 30문항 무료 진단으로 먼저 점검해 보세요.
참고한 글
· Anthropic, How Claude remembers your project, Claude Code 문서 (2026-11-06 확인)
· Gloaguen 외, Evaluating AGENTS.md, arXiv 2602.11988 (v3 2026-09-29)
· Jaroslawicz 외, How Many Instructions Can LLMs Follow at Once?, arXiv 2507.11538 (2025-07-15)
· Han 외, SWE-Skills-Bench, arXiv 2603.15401 (v2 2026-10-27)
· Lulla 외, On the Impact of AGENTS.md Files on the Efficiency of AI Coding Agents, arXiv 2601.20404 (v2 2026-03-30)
출처 링크는 원문에 모두 달아 두었습니다.